<?xml version="1.0" encoding="utf-8"?>
<?xml-stylesheet href="/feeds/atom-style.xsl" type="text/xsl"?>
<feed xmlns="http://www.w3.org/2005/Atom">
    <id>https://www.pppp.ink/</id>
    <title>PPPP.ink</title>
    <updated>2026-10-31T10:11:17.002Z</updated>
    <generator>Astro-Theme-Retypeset with Feed for Node.js</generator>
    <author>
        <name>SincereXIA</name>
        <uri>https://www.pppp.ink/</uri>
    </author>
    <link rel="alternate" href="https://www.pppp.ink/"/>
    <link rel="self" href="https://www.pppp.ink/atom.xml"/>
    <subtitle>SincereXIA 的个人博客。记录技术实践、学习笔记和生活片段。</subtitle>
    <rights>Copyright © 2026 SincereXIA</rights>
    <entry>
        <title type="html"><![CDATA[解决 clion remote development 无法通过 root 运行]]></title>
        <id>https://www.pppp.ink/blogs/12-jie-jue-clion-remote-development-wu-fa-tong-guo-root-yun-xing.html</id>
        <link href="https://www.pppp.ink/blogs/12-jie-jue-clion-remote-development-wu-fa-tong-guo-root-yun-xing.html"/>
        <updated>2025-07-11T09:27:31.000Z</updated>
        <summary type="html"><![CDATA[使用 Clion 远程开发（remote development) 时，Run/Debug 设置中若勾选了 Run with root pr...]]></summary>
        <content type="html"><![CDATA[<h2>1. 现象</h2>
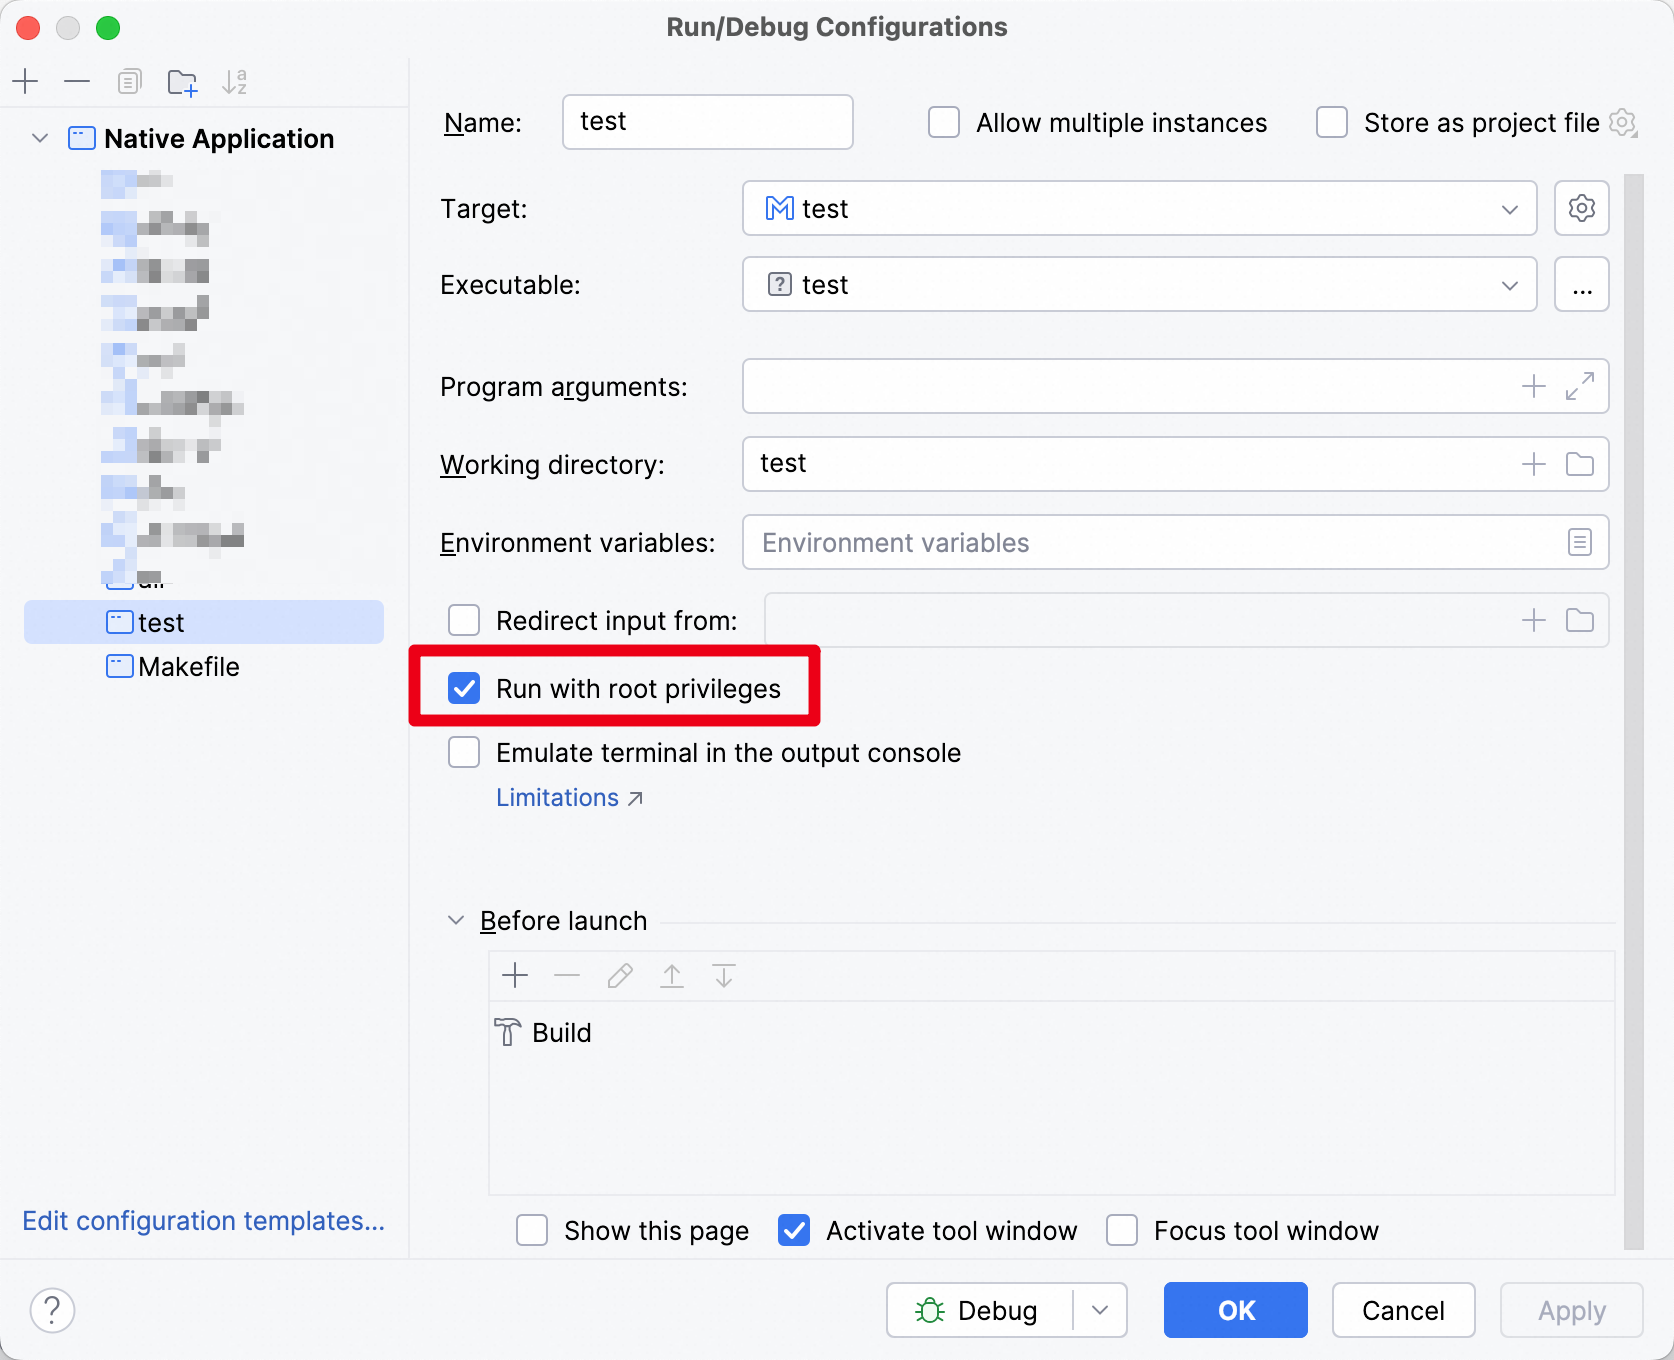
<p>使用 Clion 远程开发（remote development) 时，Run/Debug 设置中若勾选了 <code>Run with root privileges </code>， 会出现报错：<code>Elevation for remote process doesn't work : Failed to launch elevation service using 'pkexec':</code></p>
<p><img src="https://www.pppp.ink/blogs/attachments/Pasted%20image%2020250711155929.png" alt="" /></p>
<h2>2. 解决方案</h2>
<p>在 Jetbrains 中已有相同问题反馈：https://youtrack.jetbrains.com/issue/IJPL-170313/Elevation-for-remote-process-doesnt-work-Failed-to-launch-elevation-service-using-pkexec</p>
<p>评论区有人提供了解法，经测试有效</p>
<blockquote>
<p>Issue still occurs on CLion 2025.1 Build #JBC-251.23774.442, built on April 14, 2025, with Ubuntu 24.04.2 LTS.<br />
2025 年 4 月 14 日构建，搭载 Ubuntu 24.04.2 LTS 的 CLion 2025.1 Build #JBC-251.23774.442 上仍然存在问题。</p>
</blockquote>
<p>An <strong>insecure workaround</strong> (<strong>@André Lanouette</strong>) for this issue is creating a polkit rule in <code>/etc/polkit-1/rules.d</code> allowing the action <code>org.freedesktop.policykit.exec</code>. In my case, I created the file <code>10-allow-root-all-insecure.rules</code> with the content:</p>
<p>此问题的<strong>不安全解决方法</strong> （<strong>@André Lanouette</strong>） 是在 <code>/etc/polkit-1/rules.d</code> 中创建一个 polkit 规则，允许该作 <code>org.freedesktop.policykit.exec</code> 。就我而言，我创建了 <code>10-allow-root-all-insecure.rules</code> 包含以下内容的文件：</p>
<pre><code>polkit.addRule(function(action, subject) {
    if (action.id == "org.freedesktop.policykit.exec") {
        return polkit.Result.YES;
    }
})
</code></pre>
<p>The rule can (and <strong>definitely should!!!</strong>) be made more restrictive, as this would grant everybody access to <code>pkexec</code> run any command as root. I would recommend at least including <code>&amp;&amp; subject.user == "&lt;USERNAME&gt;"</code> in the conditional to restrict access to those who normally already have root access.<br />
该规则可以（ <strong>并且绝对应该!!</strong>）变得更加严格，因为这将授予每个人以 root 身份运行 <code>pkexec</code> run 任何命令的权限。我建议至少在条件中包含 <code>&amp;&amp; subject.user == "&lt;USERNAME&gt;"</code> 限制访问，以限制通常已经具有 root 访问权限的人。</p>
<p>This is how my file looks now, with more restrictive rules and is a bit more secure:<br />
这是我的文件现在的样子，规则更严格，安全性更高一些：</p>
<pre><code>polkit.addRule(function(action, subject) {
    if (action.id == "org.freedesktop.policykit.exec" &amp;&amp; 
        action.program == "/home/&lt;USERNAME&gt;/.cache/JetBrains/RemoteDev/dist/&lt;ID&gt;_CLion-2025.1/jbr/bin/java" &amp;&amp;
        subject.user == "&lt;USERNAME&gt;") {
        return polkit.Result.YES;
    }
})
</code></pre>
<h2>3. 问题可能的原因</h2>
<h3>背景</h3>
<ol>
<li>
<p><strong>pkexec</strong>：是PolicyKit（现在称为Polkit）的一个工具，允许授权用户以其他用户身份（通常是root）执行命令。它提供了一个图形化或文本界面的认证对话框，要求用户输入密码以确认权限</p>
</li>
<li>
<p><strong>Polkit</strong>：是一个用于在Unix-like操作系统中控制系统范围权限的组件。它为非特权进程与特权进程通信提供了一种机制。Polkit定义了一系列动作（actions），每个动作对应一个需要特权的操作，并指定了哪些用户（或组）可以执行这些动作，以及是否需要认证（如密码）。</p>
</li>
</ol>
<p>在远程开发环境中，当CLion尝试以root权限运行程序时，它会调用pkexec来提升权限。但是，可能因为CLion的远程代理进程（在远程机器上运行）无法弹出认证对话框，导致提权失败</p>
<p>具体来说，错误信息Failed to launch elevation service using 'pkexec'表明CLion试图通过pkexec启动一个提升权限的服务，但Polkit拒绝了该请求。</p>
<h3>解决方案原理</h3>
<p>解决方案中，我们通过创建一个Polkit规则（放在<code>/etc/polkit-1/rules.d/</code>目录下）来允许特定的动作（<code>org.freedesktop.policykit.exec</code>）在特定条件下自动被授权（返回<code>polkit.Result.YES</code>），而不需要密码认证。</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2025-07-11T15:49:30.841Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[文石 Boox Leaf 获取 Root 权限 & 修改系统字体]]></title>
        <id>https://www.pppp.ink/blogs/11-wen-shi-boox-leaf-root-xiu-gai-zi-ti.html</id>
        <link href="https://www.pppp.ink/blogs/11-wen-shi-boox-leaf-root-xiu-gai-zi-ti.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[万物 Magisk 四月初想买个墨水屏阅读器玩玩，当时也调研了好久，考虑了阅读器的系统，屏幕尺寸，阅读场景，以及我钱包的承受能力，最终入手了...]]></summary>
        <content type="html"><![CDATA[<p>万物 Magisk</p>
<p><img src="https://www.pppp.ink/images/2022-09-02-1662087856-zBW1I2.png" alt="2022-09-02-1662087856-zBW1I2" /></p>
<h2>起因</h2>
<p>四月初想买个墨水屏阅读器玩玩，当时也调研了好久，考虑了阅读器的系统，屏幕尺寸，阅读场景，以及我钱包的承受能力，最终入手了文石的 Boox Leaf，一块七英寸的墨水屏。</p>
<p>文石的阅读器直接使用了 Android 系统，完全开放，可以安装第三方 Android APP，甚至还自带 Google 框架，十分贴心。书籍的传输也非常方便，文石自带的 “互传”，可以通过 <a href="https://send2boox.com/">https://send2boox.com/</a> 快速推送文件到阅读器上，甚至在同一子网中时，可以直接从浏览器里管理阅读器内部的文件。</p>
<p>对于本地书籍的格式支持也很全面，渲染排版引擎可调节的选项很多，最新的系统版本支持书籍内图片的灰度抖动渲染，断层现象终于少了很多。但新的图像渲染方式只有系统自带的阅读工具支持，第三方 APP 完全没有优化。对于 PDF 的排版上，文石支持自动裁边，以及文字重排。自动裁边很好用，但文字重排经常会把排版弄乱，可能对于纯文本类的扫描版 PDF 书籍会有点用。</p>
<p>然而，令人不解的是，文石的系统字体居然默认是圆体，而且系统不支持自定义字体，这就让人很难受，不知道他们为什么要把字体做成圆体，实在欣赏不来，文石不但改了 Android 的默认字体，而且自带的字体居然是单字重的！对于调用了系统自带字体的 APP，阅读体验很差。</p>
<p><img src="https://www.pppp.ink/images/2022-09-01-1662035336-3wphsR.png" alt="2022-09-01-1662035336-3wphsR" /></p>
<p>虽然可以使用 “隐藏的设置项” 等 APP，调用原生 Android 的系统设置，但仍然无法调节系统默认字体，因此尝试获取 Leaf 的 Root 权限，通过 Magisk 模块的方式，修改系统字体。</p>
<h2>0. Root 前的准备</h2>
<ol>
<li>下载 App：“隐藏的设置项” 进入 AOSP 系统设置，多次点击设备版本号，打开开发者模式，并且启用 USB 调试</li>
<li>数据线接上 PC，装好 ADB 驱动和环境，输入命令：<code>adb devices</code> 查看连接状态</li>
<li>使用命令 <code>adb reboot bootloader</code> 重启进入 fastboot 模式</li>
<li><code>fast boot flashing unlock</code> 检查 bootloader 锁是否解除，文石 Boox 3.2.3 Android 10 的版本出场 bootloader 就没有上锁，非常适合折腾，十分好评</li>
</ol>
<h2>1. 下载固件，提取 boot.img</h2>
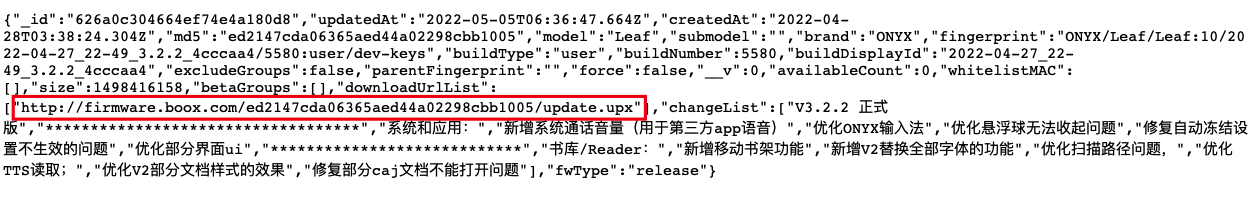
<p>文石的固件很独特，从服务器下载到的固件是加密的，而且官网也不给出最新固件的下载地址。github 有大佬给出了一个固件下载的接口，我们访问这个网址：</p>
<pre><code>http://data.onyx-international.cn/api/firmware/update?where={%22buildNumber%22:0,%22buildType%22:%22user%22,%22deviceMAC%22:%22%22,%22lang%22:%22zh_CN%22,%22model%22:%22Leaf%22,%22submodel%22:%22%22,%22fingerprint%22:%22%22}
</code></pre>
<p>会得到以下结果：</p>
<p><img src="https://www.pppp.ink/images/2022-09-02-1662086513-R2EZOv.png" alt="2022-09-02-1662086513-R2EZOv" /></p>
<p>其中，<code>downloadUrlList</code> 字段记录了固件的下载链接。</p>
<p>可以将其中的 "model" 属性值调整为其他设备的 ID，就可以下载到其他设备的最新固件</p>
<p>固件下载好后，来这里下载好解密脚本：<a href="https://github.com/Hagb/decryptBooxUpdateUpx">https://github.com/Hagb/decryptBooxUpdateUpx</a> 装好 python 环境</p>
<p>终端执行：<code>python DeBooxUpx.py leaf update.upx</code> 解密固件包，解密出 zip 格式压缩包。但该压缩包在 macos 中无法直接解压，需要使用 Keka 进行解压。</p>
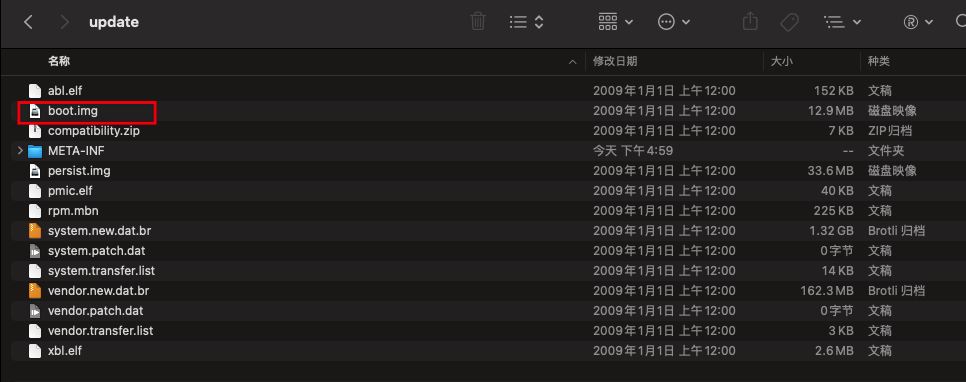
<p>解压后就拿到了我们需要的 boot.img</p>
<p><img src="https://www.pppp.ink/images/2022-09-01-1662036275-vgRxrn.png" alt="2022-09-01-1662036275-vgRxrn" /></p>
<h2>2. 使用 Magisk 修补 boot.img</h2>
<ol>
<li>给任意一台 Android 设备安装好 Magisk APP: <a href="https://github.com/topjohnwu/Magisk/releases">https://github.com/topjohnwu/Magisk/releases</a></li>
<li>将上文提取出的 boot.img 发送给 Android 设备，打开手机 Magisk 应用 &gt; 安装 &gt; 选项中只勾选保持系统分区加密 &gt; 选择并修补一个文件 &gt; 选择复制进去的 boot.img &gt; 开始。等待滚动的命令行显示 All Done</li>
<li>将生成的 <code>magisk_patched-xxxxxx.img</code> 发送给 PC</li>
</ol>
<h2>3. 使用修补过的 boot.img 引导启动文石阅读器</h2>
<ol>
<li>文石 Leaf 进入 fastboot 模式，<code>fastboot boot magisk_patched-xxxxxxx.img</code>，等待设备重新启动</li>
<li>重启之后进入 magisk，可以看到现在设备已经获得了 root 权限，但这只是临时的</li>
<li>确认启动引导没有问题后，打开 Magisk App 中选择安装 &gt; 直接安装，永久修补 boot 镜像。</li>
</ol>
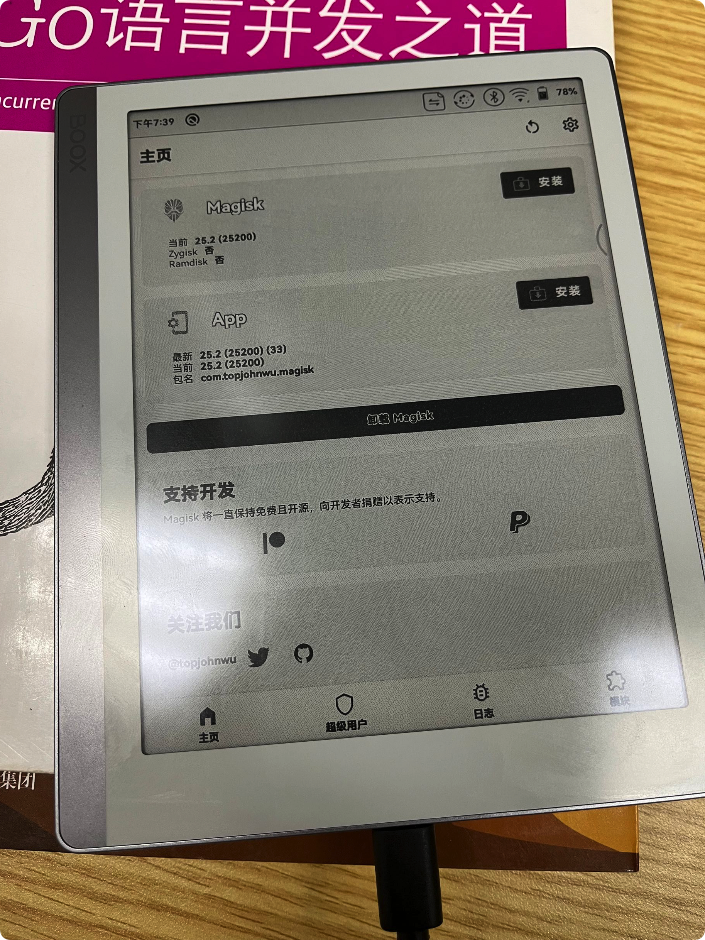
<p>至此，文石 leaf Root 成功</p>
<p><img src="https://www.pppp.ink/images/2022-09-02-1662087429-O2pwcq.png" alt="2022-09-02-1662087429-O2pwcq" /></p>
<h2>4. 修改系统字体</h2>
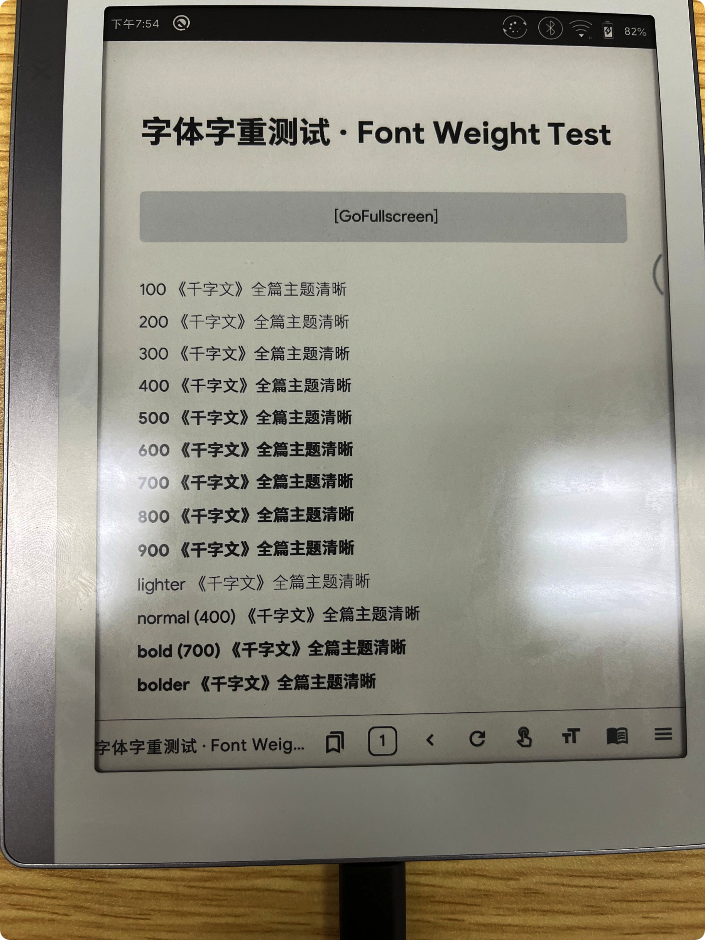
<p>拥有 Magisk 之后，修改系统字体就很简单，只需要找一些包含多字重的字体模块刷入即可，一些字体模块可以在这里下载：<a href="https://magisk.suchenqaq.club/MagiskModule/Font.php">https://magisk.suchenqaq.club/MagiskModule/Font.php</a></p>
<p><img src="https://www.pppp.ink/images/2022-09-02-1662087378-gaOOyG.png" alt="2022-09-02-1662087378-gaOOyG" /></p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2022-09-01T12:12:02.874Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Kubernetes 节点 OOM 问题排查和处理经过]]></title>
        <id>https://www.pppp.ink/blogs/10-kubernetsjie-dian-oompai-cha.html</id>
        <link href="https://www.pppp.ink/blogs/10-kubernetsjie-dian-oompai-cha.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[真相永远只有一个！研究生毕设的测试和实验打算再 K8s 集群上进行，于是需要先部署一个 k8s 集群环境。前两周分配了十台虚拟机搭建了一个...]]></summary>
        <content type="html"><![CDATA[<p>真相永远只有一个！</p>
<h2>起因</h2>
<p>研究生毕设的测试和实验打算再 K8s 集群上进行，于是需要先部署一个 k8s 集群环境。前两周分配了十台虚拟机搭建了一个 3 master + 7 worker 的高可用 K8s 集群，但当时就出现了因为节点 OOM，系统进程被杀死导致节点宕机最后整个集群都崩溃的问题。当时以为是虚拟机内存开太小了，或者是虚拟机使用了网络存储的问题，重装了一遍，然后没有在意。直到这周，沃老师让我在十台物理服务器上部署 k8s 集群，这十台服务器每个都有 188G 内存，结果相同的情况再次出现。于是不得不去寻找集群节点崩溃的真实原因。</p>
<h2>问题表现</h2>
<p>部署好 k8s 集群之后，刚开始一切正常，但每次我部署完 kubesphere 之后，集群部分节点就会处于 NotReady 状态。但这些机器一般还可以通过 ssh 进行连接，我尝试过直接重启这些 NotReady 的节点，但这些节点在刚开机时使用 <code>kubectl get nodes</code> 仍然处于 Ready 状态，可是没过一会儿就又自动掉线了。</p>
<h2>问题排查</h2>
<h3>v1.0</h3>
<p>联系能连上远程控制台的 BW 兄，发现了这些节点故障的原因：</p>
<p><img src="https://www.pppp.ink/images/2022-01-09-1641693199-fMdgnH.png" alt="2022-01-09-1641693199-fMdgnH" /></p>
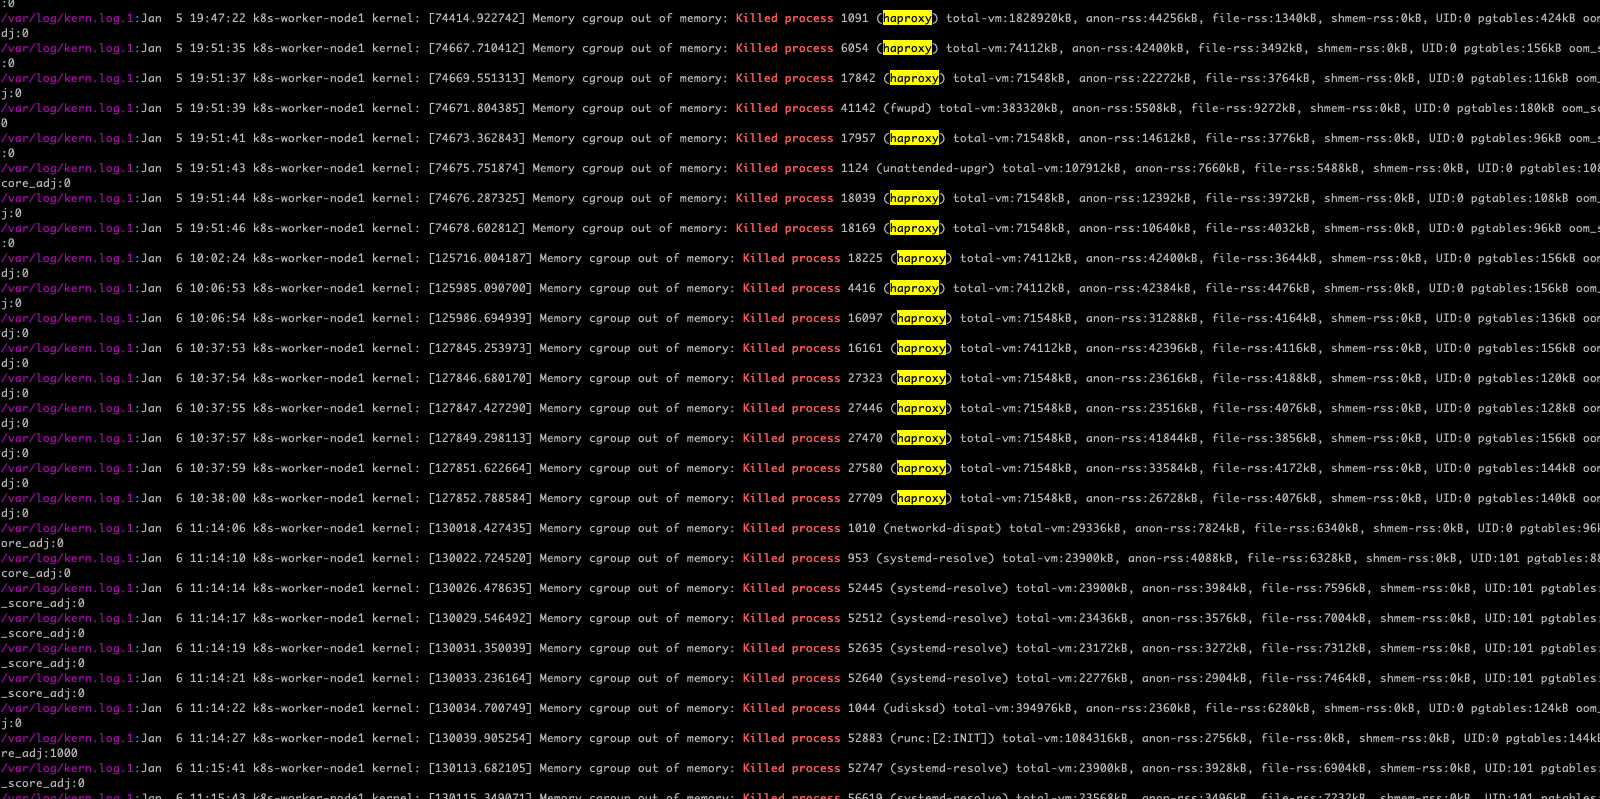
<p>节点重启后，查看一下 OOM 日志：</p>
<pre><code>egrep -i -r 'killed process' /var/log
</code></pre>
<p><img src="https://www.pppp.ink/images/2022-01-09-1641693399-rSpcz7.png" alt="2022-01-09-1641693399-rSpcz7" /></p>
<p>可以看到，大量的系统进程被杀死，k8s 的高可用代理 <code>haproxy</code> 赫然在列。所以，原因找到了！因为我的 <code>haproxy</code> 没有配置对，导致内存占用过大，触发了 OOM，由于 <code>haproxy</code> 挂掉之后，Worker 节点无法连接到 master，从而显示为 NotReady。</p>
<h3>v2.0</h3>
<p>问题就这么轻松的解决了？NO！</p>
<p>在尝试修改了多次 haproxy 配置后，worker 节点还是会大量触发 OOM，haproxy 进程仍然频繁被杀死。再仔细看日志，发现 haproxy 被杀掉之前，它内存占用并不大，只有几兆而已。就这点内存居然会被一个 188G 内存的服务器挑出来杀掉，实在不可思议。</p>
<p>后续又发现，每次 haproxy 挂掉的时候，DNS 解析也大概率会挂掉（systemd-resolved）,日志里面也提示了 <code>Memory cgroup out of memory</code>。所以，我猜可能是 cgroup 配置的问题，haproxy 所在的 cgroup 内存限制太小了。</p>
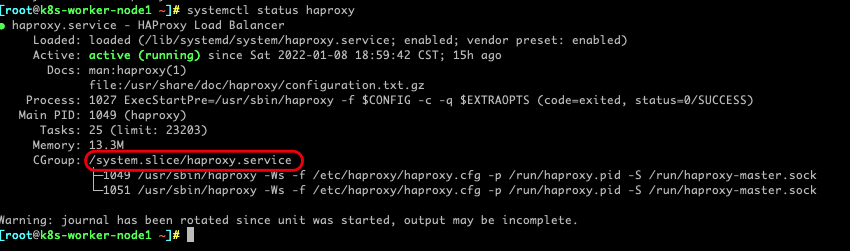
<p>我们看看 haproxy 位于哪个 cgroup</p>
<pre><code>systemctl status haproxy
</code></pre>
<p><img src="https://www.pppp.ink/images/2022-01-09-1641694030-AP7TCW.png" alt="2022-01-09-1641694030-AP7TCW" /></p>
<p>看一下这个 cgroup 的限制</p>
<pre><code>cd /sys/fs/cgroup/memory/system.slice/
cat haproxy.service/memory.limit_in_bytes
</code></pre>
<p><img src="https://www.pppp.ink/images/2022-01-09-1641694149-LXyXTJ.png" alt="2022-01-09-1641694149-LXyXTJ" /></p>
<p><code>9223372036854771712</code> 这么大的内存，没啥问题啊。</p>
<p>那只能看看上一级的内存限制了：</p>
<p><img src="https://www.pppp.ink/images/2022-01-09-1641694260-U9vMOp.png" alt="2022-01-09-1641694260-U9vMOp" /></p>
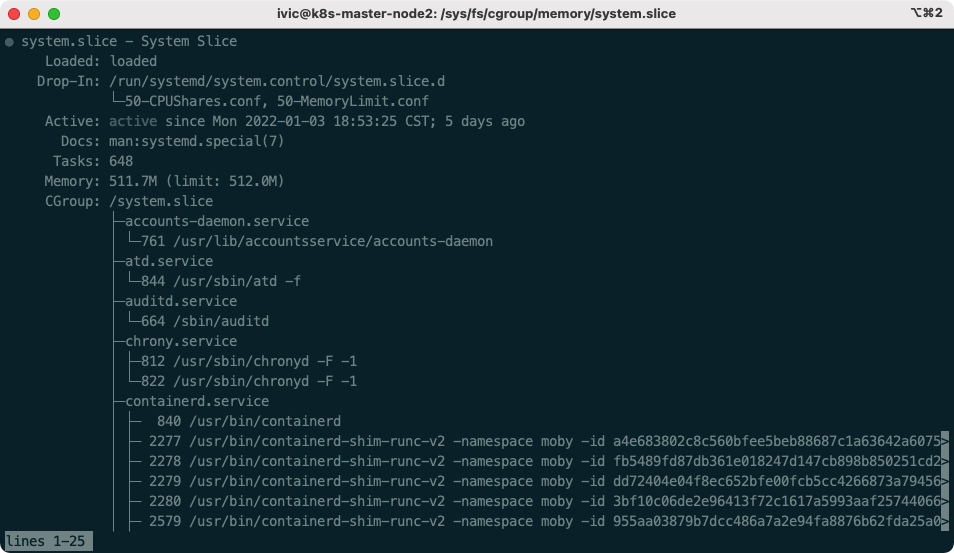
<p><code>536870912</code> 字节！，问题找到了，整个 <code>system.slice</code> 被限制到了 0.5 G ! 我们验证一下：</p>
<p><img src="https://www.pppp.ink/images/2022-01-09-1641694357-lituMP.png" alt="2022-01-09-1641694357-lituMP" /></p>
<p>果然！<code>Memory: 511.7M (limit: 512.0M)</code>，这么大的内存他不用，把整个系统进程的可用内存限制在了 0.5G，不到整个节点内存的 1/200</p>
<p>尝试修复：</p>
<pre><code>systemctl set-property system.slice CPUShares=1024
systemctl set-property system.slice MemoryLimit=infinity
</code></pre>
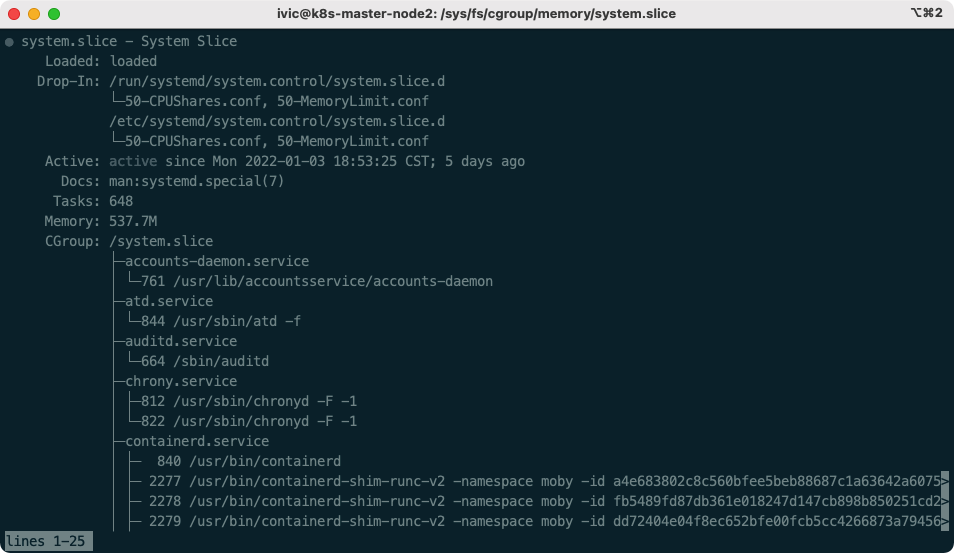
<p>去除了对 system 的 CPU 和内存限制，再看看</p>
<p><img src="https://www.pppp.ink/images/2022-01-09-1641694533-aE9XHW.png" alt="2022-01-09-1641694533-aE9XHW" /></p>
<p>诶，限制没有了，好了！</p>
<h2>v3.0</h2>
<p>你以为这就结束了？native！</p>
<p>节点重启之后，system 的可用内存又被重新限制到了 0.5 G，仿佛我所有的努力都没有发生过。</p>
<p>查阅了一些资料，通过 <code>systemctl set-property</code> 设置的配置应该是持久化的，不应该重启失效才对。为了排除是 Ubuntu 20.4 系统本身的问题，我用相同的镜像重装了一个系统，发现系统默认是没有 0.5 G 内存限制的。那一定是在其他的地方偷偷改了我的配置！</p>
<p>会是谁呢？我这个集群只装了 k8s，那一定是配置 k8s 的过程当中导致的。</p>
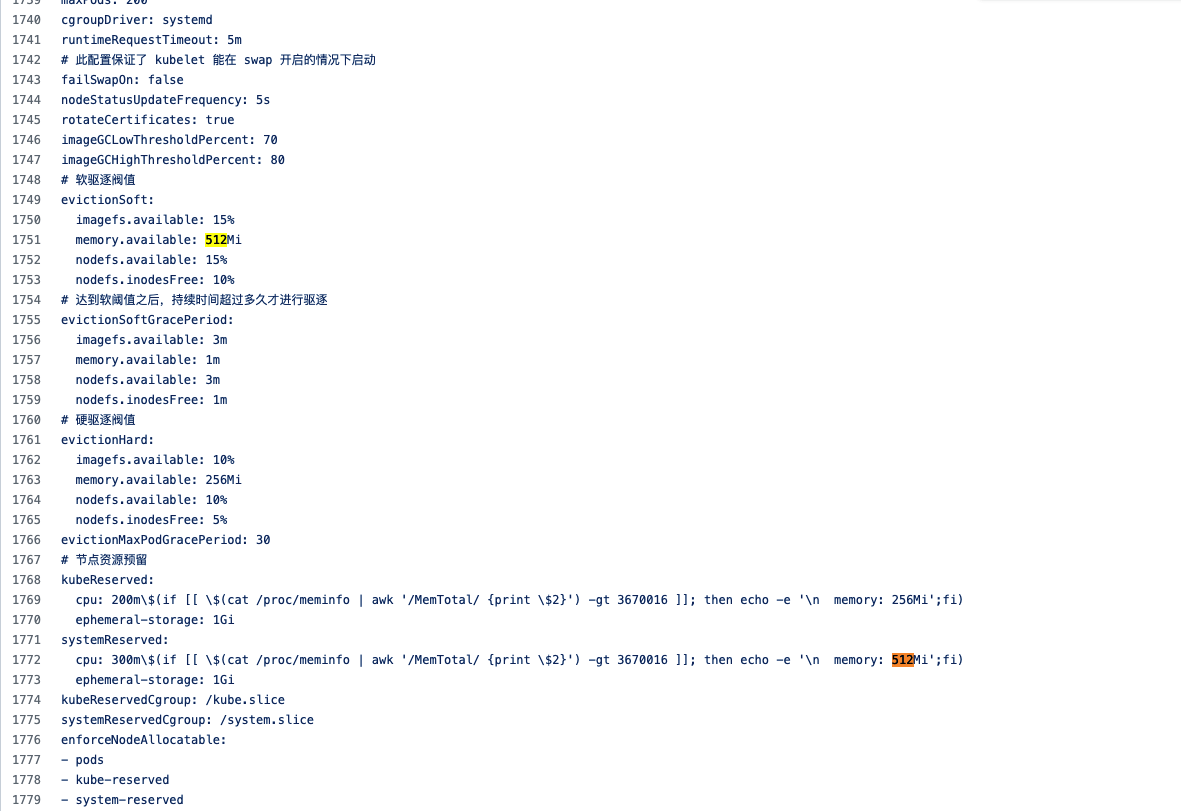
<p>仔细查找我安装 k8s 的配置和脚本，在一个不起眼的地方发现了一个嫌疑人</p>
<p><img src="https://www.pppp.ink/images/2022-01-09-1641694868-KyLH4C.png" alt="2022-01-09-1641694868-KyLH4C" /></p>
<pre><code># 节点资源预留
kubeReserved:
  cpu: 200m
  memory: 256Mi
  ephemeral-storage: 1Gi
systemReserved:
  cpu: 300m
  memory: 512Mi
  ephemeral-storage: 1Gi
kubeReservedCgroup: /kube.slice
systemReservedCgroup: /system.slice
</code></pre>
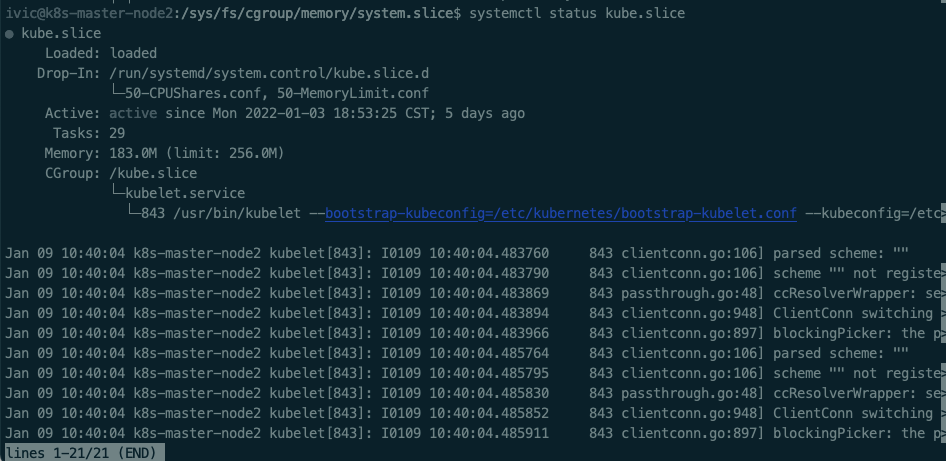
<p><code>512M</code>！除了这里，我再也找不到类似的内存限制了，和 system.slice 一起限制的还有 kube.slice，我们也来看看他：</p>
<p><img src="https://www.pppp.ink/images/2022-01-09-1641696175-gIVG4j.png" alt="2022-01-09-1641696175-gIVG4j" /></p>
<p>果然 <code>256M</code>!，看到这里，这个嫌疑基本实锤了！让我苦苦寻找了三天的问题，就是他！</p>
<p>但这里 <code>systemReserved</code> 明明看字面意思是资源预留，查询官方文档也是给系统进程预留资源，但为什么变成了资源限制呢？</p>
<p>跟本原因是 <code>enforceNodeAllocatable</code> 这个字段的配置问题。</p>
<blockquote>
<p>我理解错了 enforceNodeAllocatable 的意思了，我以为它是开关，实际上是给这几个创建 cgroup。reserved 配置了就会减去分配的配额，它开了就会强制 cgroup 限制 kube 和 systemd 来预留，也是不推荐配置的。取消它的配置为下面相关：</p>
</blockquote>
<p>来源：<a href="https://zhangguanzhang.github.io/2021/08/16/reserve-compute-resources/#%E5%9D%91">https://zhangguanzhang.github.io/2021/08/16/reserve-compute-resources/#坑</a></p>
<h2>修复</h2>
<p>之后，ssh 到每个节点上，修改配置文件：<code>/var/lib/kubelet/config.yaml</code>，将 <code>kube-reserved</code>、<code>system-reserved</code> 从 <code>enforceNodeAllocatable</code> 中删除：</p>
<pre><code>enforceNodeAllocatable:
  - pods
#  - kube-reserved
#  - system-reserved
</code></pre>
<p>修改之后需要重启节点，方可解除内存限制。</p>
<p><strong>至此，问题解决</strong></p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2022-01-01T02:56:31.378Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[鹅厂实习面试经历]]></title>
        <id>https://www.pppp.ink/blogs/8-e-han-shi-xi-mian-shi-jing-li.html</id>
        <link href="https://www.pppp.ink/blogs/8-e-han-shi-xi-mian-shi-jing-li.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[流水账而已，没什么好看的 在某个风和日丽阳光明媚的下午，又像往常一样一觉睡到三点半，醒来之后发现师兄联系我：菜鸡一个感到非常害怕，本来正在无...]]></summary>
        <content type="html"><![CDATA[<p>流水账而已，没什么好看的</p>
<p><img src="https://www.pppp.ink/images/2021-12-04-1638585073-4hmj5n.png" alt="2021-12-04-1638585073-4hmj5n" /></p>
<h2>起因</h2>
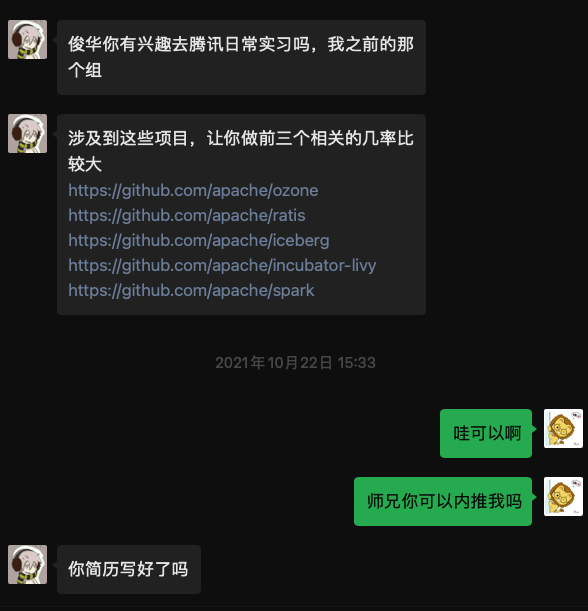
<p>在某个风和日丽阳光明媚的下午，又像往常一样一觉睡到三点半，醒来之后发现师兄联系我：</p>
<p><img src="https://www.pppp.ink/images/2021-11-05-1636116165-BkK4m0.png" alt="2021-11-05-1636116165-BkK4m0" /></p>
<p>菜鸡一个感到非常害怕，本来正在无忧无虑地开题，现在突然整了这么一出。</p>
<p>但是呢，总感觉这样放弃一个机会有点可惜。于是答应了师兄，周一给师兄简历。</p>
<p>接下来是周六周日，周六上午重新整了整保研时写的简历，新加了一些项目经验，删了删本科经历。问 fk 要来他简历看了看，更加坚定了我是真菜。</p>
<h2>投简历</h2>
<p>周一的时候还在犹豫，问了问 gj 兄，gj 说他也要投，ok，那我也更风投吧（p.s. gj 直到我三面的前一个晚上才投出去他的简历）</p>
<p>简历发给师兄后，很快有个小哥给我打电话，给我发了伯乐马，结果我一扫，发现我之前已经在腾讯投过简历了，回想起来，那还是上本科的时候，但那次投完，连个面试机会都没有，根本没人捞我。好叭，只好再官网重投一遍，官网投递简历不仅要上传 pdf，还需要把简历里面的内容在网页的表单里面重新填写一遍。</p>
<p><img src="https://www.pppp.ink/images/2021-11-05-1636116895-drrzHp.png" alt="2021-11-05-1636116895-drrzHp" /></p>
<p>接下来，就是忐忑等待了。</p>
<h2>技术面试</h2>
<h3>一面</h3>
<p>一面安排的非常快，周一投递简历，周二早晨开组会的时候就有了初试邀请，约我周三晚上七点面试。</p>
<p>一面是个小姐姐，上来问 Raft，问项目，问计组，问计网，最后做题，具体问了啥就不讲了，毕竟还有什么保密协议。现在回想起来，有些问题回答的并不好，不过这些我确实不知道就是了，但感觉更遗憾的是最后的题并没有写对。</p>
<p>讲真，在面试官在线的情况下手撕代码，和平常刷题的感觉完全不一样，完全无法静下来思考，面试时候用笔记本电脑，那个键盘手感真的垃圾，经常按错。</p>
<h3>二面</h3>
<p>一面结束后的第三天，发来了二面邀请，二面就安排到了下一周周二，中午两点半。感谢室友中午没回宿舍，我就直接在宿舍开始面试了。</p>
<p><img src="https://www.pppp.ink/images/2021-12-04-1638583808-HbQncl.png" alt="2021-12-04-1638583808-HbQncl" /></p>
<p>二面的小哥感觉十分冷酷，感觉不苟言笑的样子。二面还是问 Raft、问项目，面试的问题还没有一面多，面试时间也更短一些，最后还是写代码，这次感觉好一些。</p>
<h3>三面</h3>
<p>二面结束后官网流程并没有更新，过了一天之后又变成了复试等待安排面试状态，本来我以为腾讯的技术面只有两面，结果现在突然感觉又要再面试一次，非常不爽。</p>
<p>三面安排到了周五中午，实际面试下来感觉自己白紧张了，整场面试就是自己做了道题，讲真，腾讯每次面试越问越少。</p>
<h2>后续流程</h2>
<h3>hr 面</h3>
<p>hr 面又到了下一周，面试我的 Hr 是一个小哥哥，感觉就是走个形式，确定一下能参与实习的时间，问一问觉得自己有什么优势之类的，hr 面刚结束就发来了云证和综合素质测评。</p>
<p><img src="https://www.pppp.ink/images/2021-12-04-1638583987-O1vrZf.png" alt="2021-12-04-1638583987-O1vrZf" /></p>
<p><img src="https://www.pppp.ink/images/2021-12-04-1638584066-oaBS7E.png" alt="2021-12-04-1638584066-oaBS7E" /></p>
<p>之前做过华为的类似测评，感觉腾讯的这个测评设计的更好一些，大部分题目都设计了一个具体的场景，询问你遇到这种场景后，你会怎么去想。或者是给你一句陈述（名言金句），让你选择最能佐证这句话的观点是什么。每道题四个选项，其中两个选项错的离谱，二选一选一个最正确的就可以。</p>
<h3>入职指引</h3>
<p>综合测评我很顺利，网上看有人综合测评挂掉的，但还可以重做几次（想想当年我居然挂掉了华为性格测试）。又过了一周，入职指引才姗姗来迟。</p>
<p><img src="https://www.pppp.ink/images/2021-12-04-1638584470-C3dw3E.png" alt="2021-12-04-1638584470-C3dw3E" /></p>
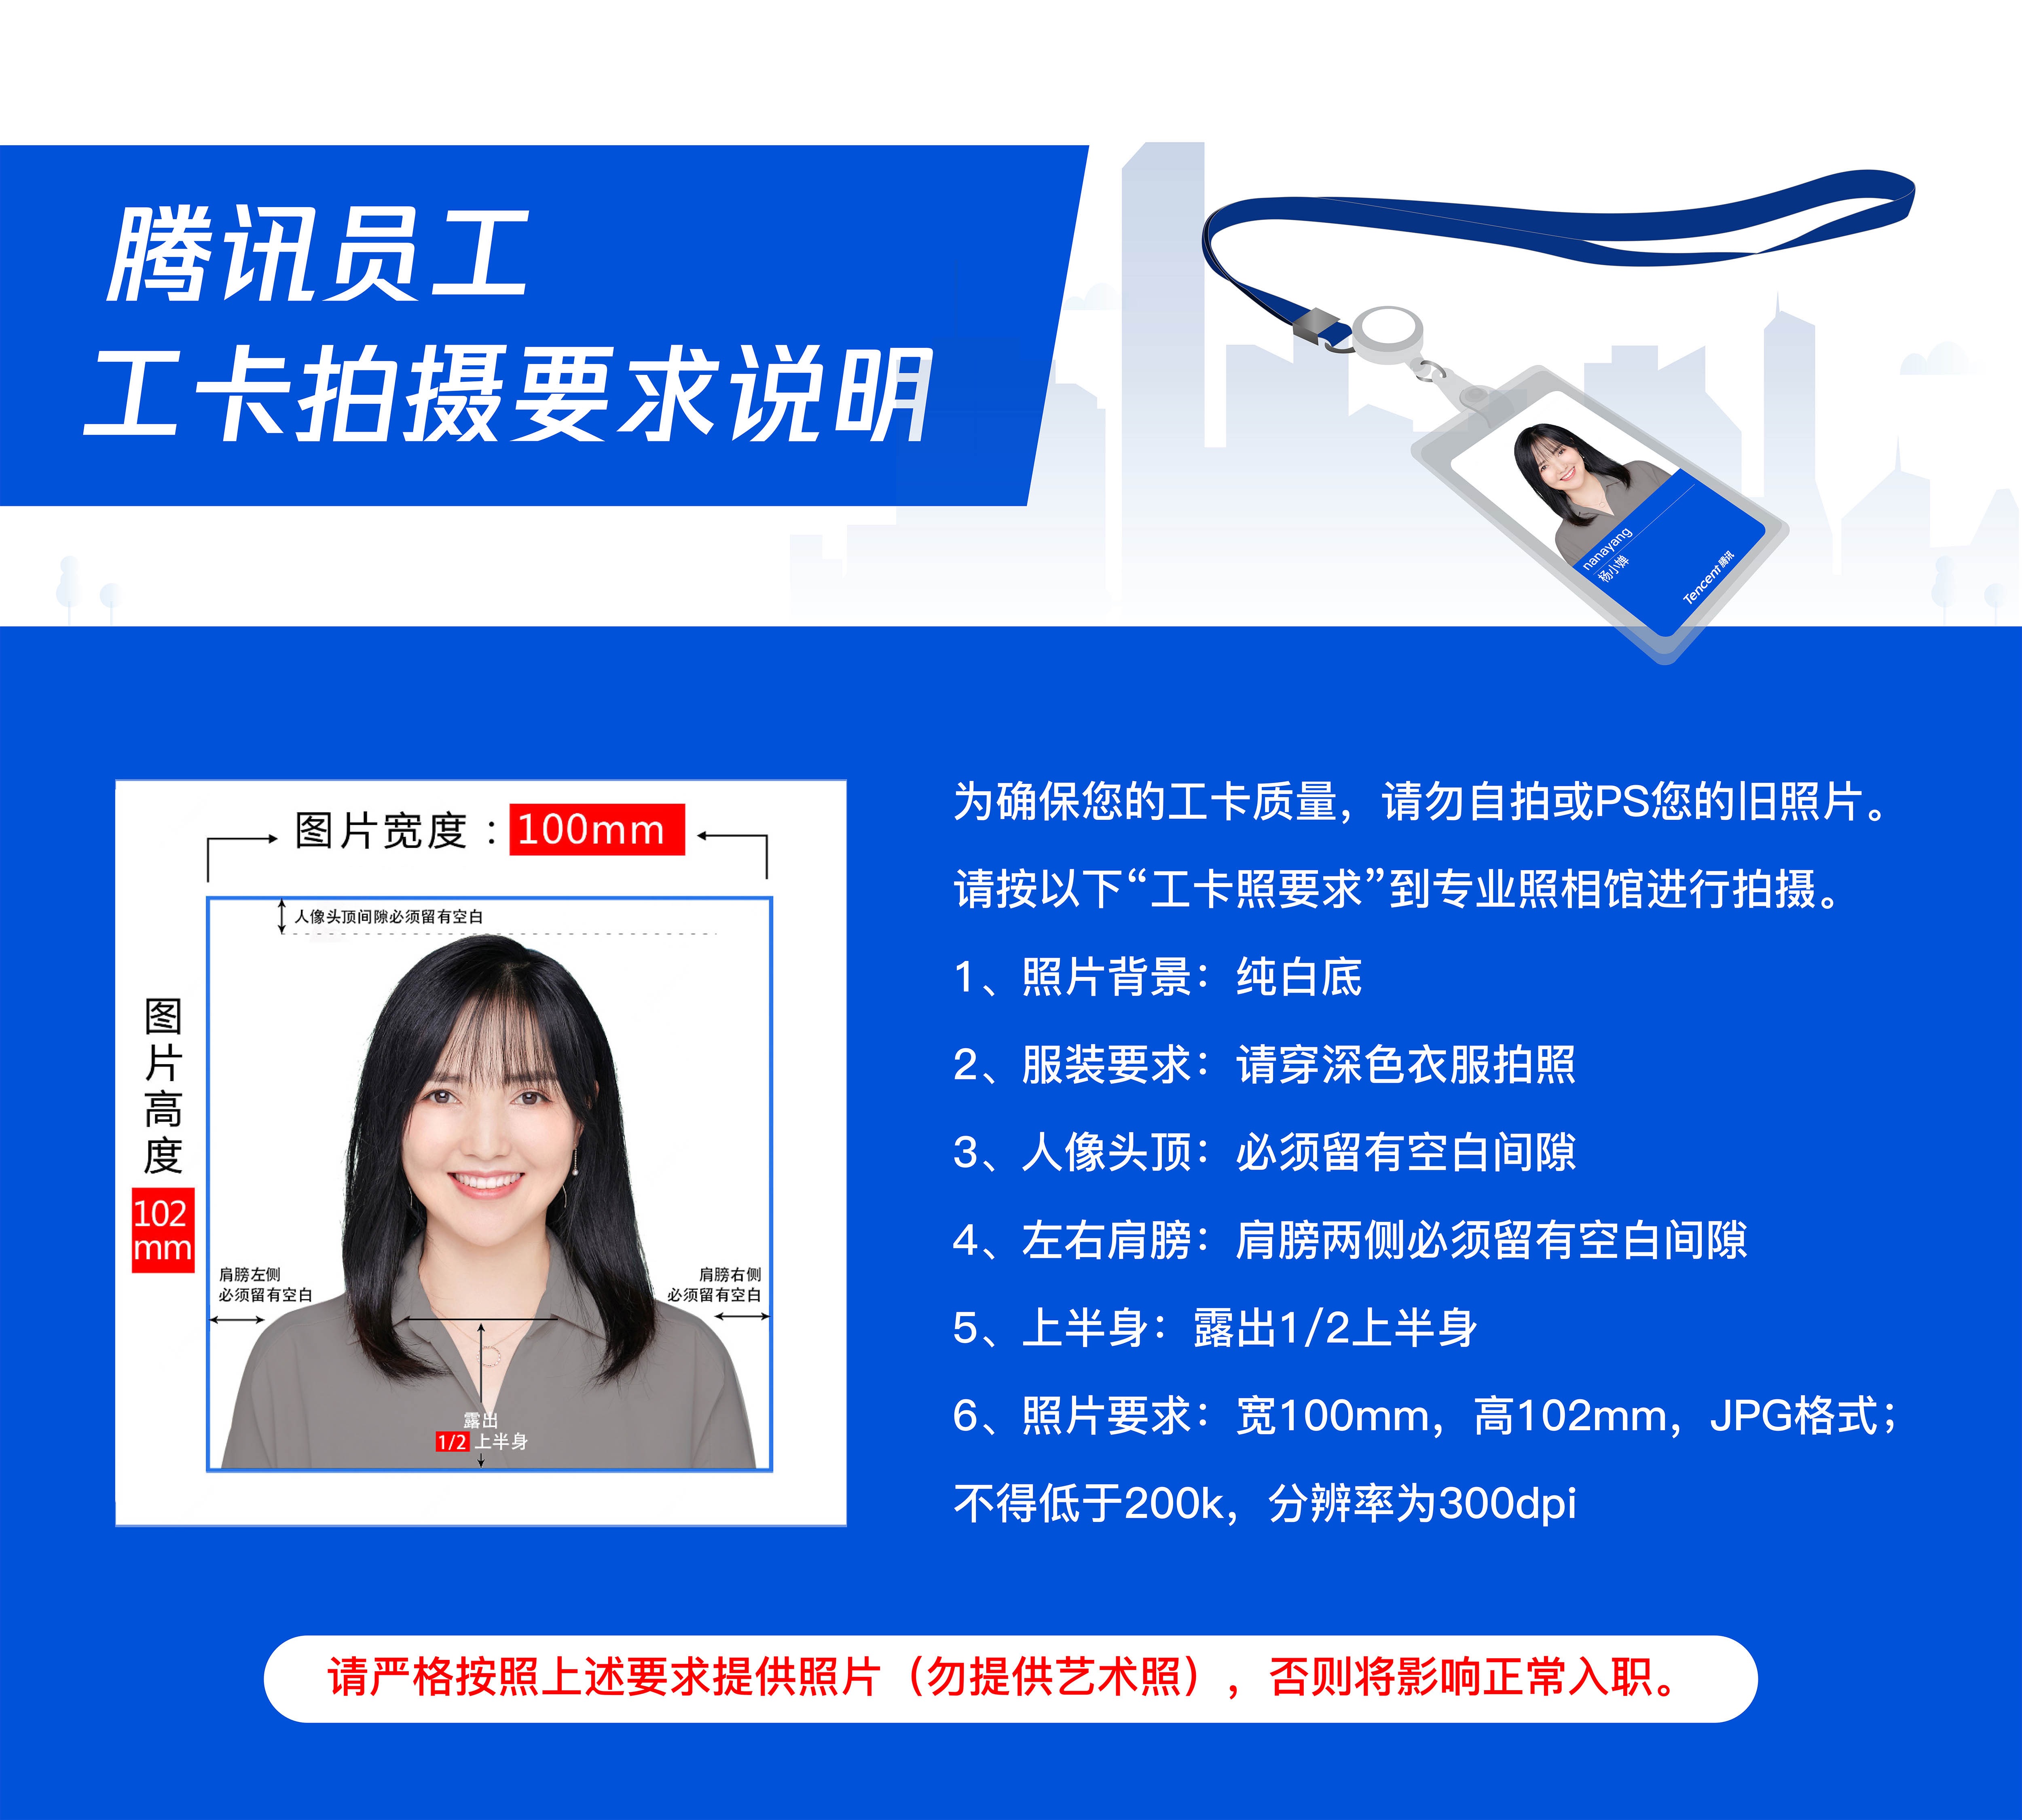
<p>腾讯入职除了需要填写一堆信息，还得上传工卡照以及银行卡。</p>
<p><img src="https://www.pppp.ink/images/2021-12-04-1638584705-4NrtGO.jpg" alt="2021-12-04-1638584705-4NrtGO" /></p>
<p>就离谱，还得露出肩膀两侧空白间隙。但我的一寸照不能满足要求，我也懒得再为了这个去重拍证件照了。所以我去找万能的淘宝，果然可以 P 一张出来。虽然 P 的效果一般般，但还看的过去，幸运的是腾讯也没卡我工卡照的问题。</p>
<p>然后就是银行卡，银行卡必须是本人招商银行的。我也懒得去线下办卡了，于是就走了招商银行线上办卡流程。填写个人信息后，第二天就有银行职员联系我，发给我一张银行卡的照片，就可以走完入职流程了。但卡他还不邮给我，要等到入职之后邮到腾讯办公楼。</p>
<p>起名字，腾讯入职要求必须起一个英文名（准确的说是两个），规则是 英文名 + 中文姓氏拼音。 简直离谱，绝大多数的英文名全都被占用了，纠结了好久，而且据说这个英文名入职之后再也没法改。</p>
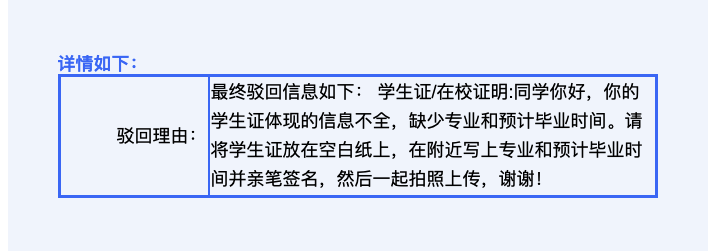
<p>提交信息之后还被驳回了一次，怪我没仔细看邮件要求</p>
<p><img src="https://www.pppp.ink/images/2021-12-04-1638585192-eYu8pe.png" alt="2021-12-04-1638585192-eYu8pe" /></p>
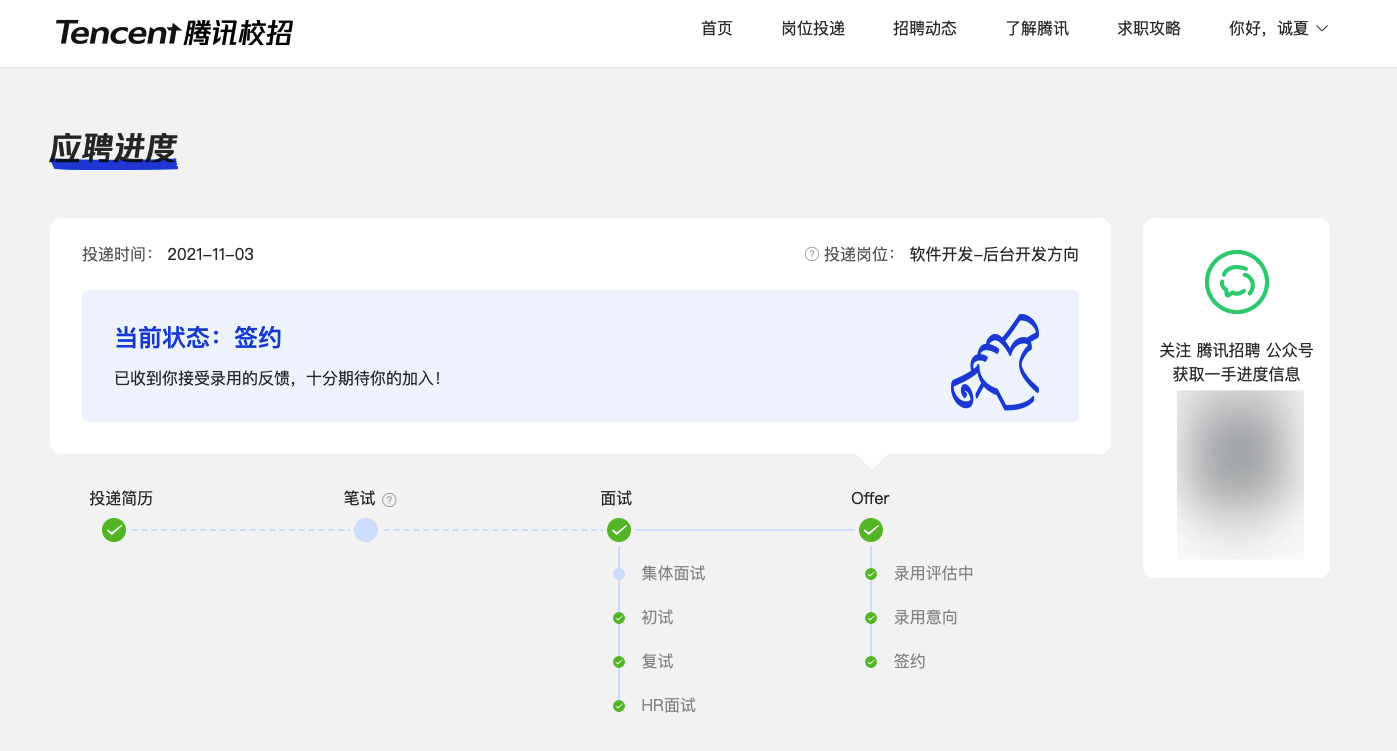
<p>总之，腾讯实习面试流程就结束了，不出所料，大厂流程啰里啰嗦。从一个实习面试流程，也可以一瞥鹅厂这个复杂系统背后的复杂度。各种关系错综复杂相互制衡慢慢演化，而我的位置又会在哪。</p>
<p><img src="https://www.pppp.ink/images/2021-12-04-1638586007-HSVit5.png" alt="2021-12-04-1638586007-HSVit5" /></p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-11-05T12:36:30.841Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[使用 WinDbg 分析 Windows 系统蓝屏日志]]></title>
        <id>https://www.pppp.ink/blogs/7-windows_windbg.html</id>
        <link href="https://www.pppp.ink/blogs/7-windows_windbg.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[记录一次因为驱动问题引发 Windows 蓝屏的排查过程 假期最近在家使用电脑时，电脑频繁出现死机蓝屏状况，为了定位蓝屏原因，需要分析操作系...]]></summary>
        <content type="html"><![CDATA[<p>记录一次因为驱动问题引发 Windows 蓝屏的排查过程</p>
<p><img src="https://www.pppp.ink/images/nuTkm8G1HesO6KM.png" alt="" /></p>
<h2>起因</h2>
<p>假期最近在家使用电脑时，电脑频繁出现死机蓝屏状况，为了定位蓝屏原因，需要分析操作系统崩溃时产生的 Dump 文件。</p>
<h2>背景</h2>
<h3>Windows 蓝屏时，Windows 在做什么</h3>
<blockquote>
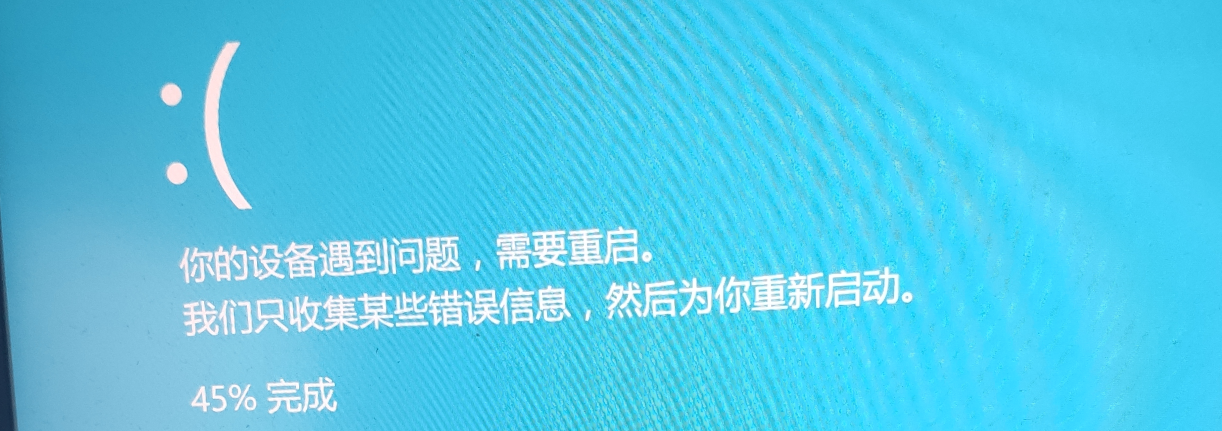
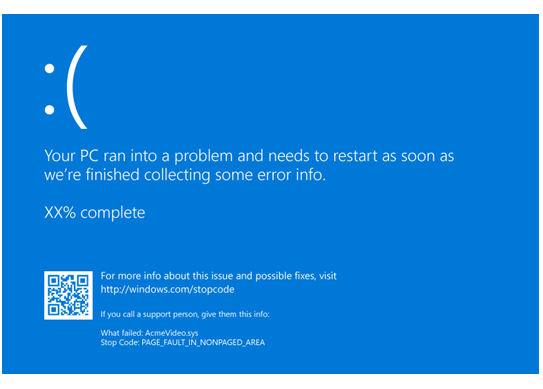
<p>当 Microsoft Windows 10 系统遇到影响其自身安全运行的情况时，产品将自动停止运行。这种 “自动停止运行” 的现象被称为 “Bug Check” (中文名称为 “错误检查”、“系统崩溃”、“内核错误” 或 “停止错误”)。通常情况下，Windows 10 系统将会在自动停止运行前面向电脑屏幕显示 蓝色 背景颜色的错误提示信息，因此这种现象也被称为电脑 “蓝屏” 异常。</p>
</blockquote>
<p><img src="https://www.pppp.ink/images/cFkN4fVnrPwjH2e.png" alt="" /></p>
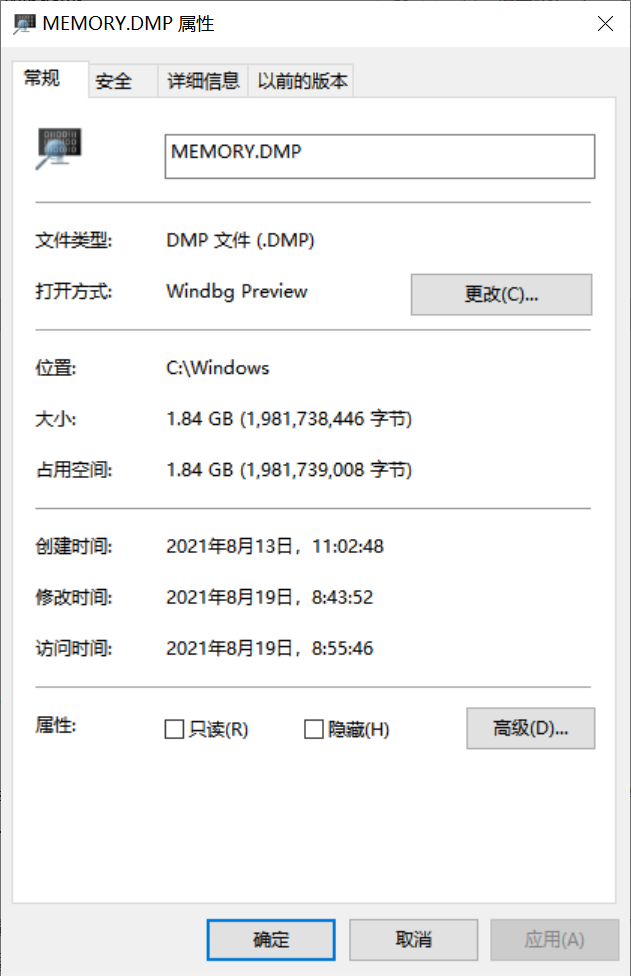
<p>在系统崩溃时，Windows 操作系统会收集当前内存中的进程信息，自动创建日志（Dump）文件，崩溃后的日志信息会记录在：<code>C:\Windows\Minidump</code> 目录下。当开启了 “崩溃转储” 功能后，系统还会生成 <code>C:\WINDOWS\MEMORY.DMP</code> 文件，该文件包含了系统当前内存（&amp;虚拟内存）中的全部有效数据，该 Dump 文件体积通常较大，可以看到，我这次系统崩溃创建出的内存镜像高达 1.8 GB</p>
<p><img src="https://www.pppp.ink/images/um6d2FvBo7cLjnl.png" alt="Memory.dmp" /></p>
<p>记录 MEMORY.DMP 的方法为：控制面板\所有控制面板项\系统  高级系统设置→启动和故障修复 的 ‘设置’→勾选‘将事件写入系统日志’</p>
<h3>Dump 文件</h3>
<blockquote>
<p>Dump 文件又叫内存转储文件或者叫内存快照文件。是一个进程或系统在某一给定的时间的快照。比如在进程崩溃时或则进程有其他问题时，甚至是任何时候，我们都可以通过工具将系统或某进程的内存备份出来供调试分析用。dump文件中包含了程序运行的模块信息、线程信息、堆栈调用信息、异常信息等数据。</p>
</blockquote>
<p>Dump 文件还可进一步分为 Full Dump 和 Mini Dump。 上文中提到的 <code>C:\Windows\Minidump</code> 目录下的 dump 文件，属于 Mini Dump</p>
<blockquote>
<ul>
<li>Minidump
随着Windows XP，微软发布了一组新的被称为“minidump”的崩溃转存技术。Minidump很容易定制。按照最常用的配置，一个minidump只包括了最必要的信息，用于恢复故障进程的所有线程的调用堆栈，以及查看故障时刻局部变量的值。这样的dump文件通常很小（只有几K字节）。所以，很容易发送给软件开发人员。一旦需要，minidump甚至可以包含比原来的crash dump更多的信息。</li>
</ul>
</blockquote>
<h3>分析 Dump 文件 —— WinDbg</h3>
<p>WinDbg 是对 KD（内核调试器）以及 NTSD（用户模式调试器）的图形化封装。
关于调试工具的更详细介绍，可以查阅 <a href="https://docs.microsoft.com/zh-cn/windows-hardware/drivers/debugger/">Microsoft 文档</a></p>
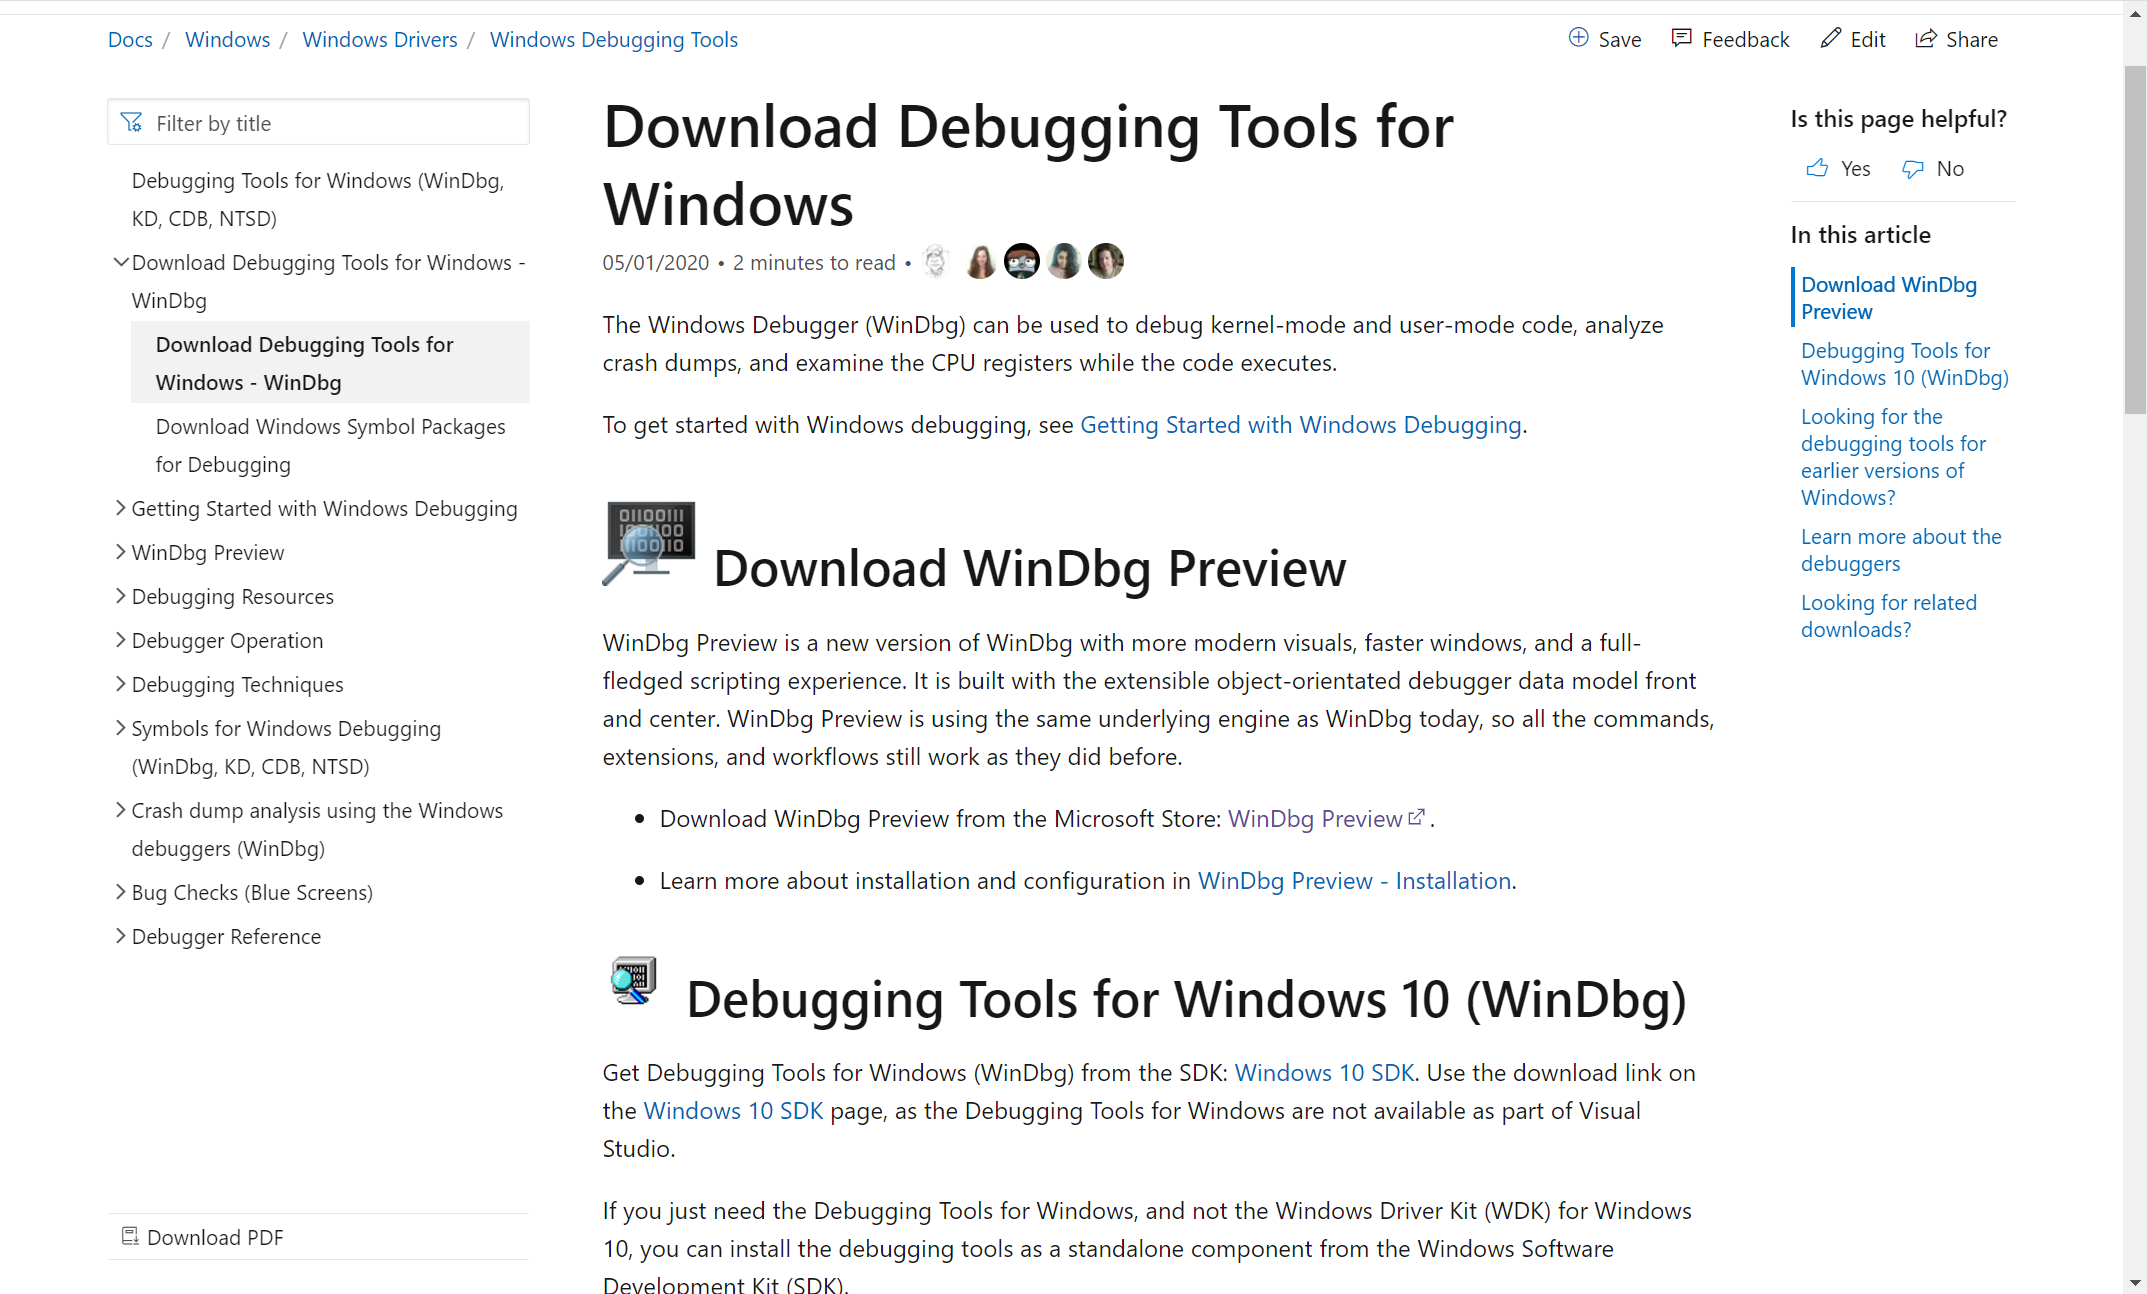
<p>WinDbg 可以从 <a href="https://docs.microsoft.com/en-us/windows-hardware/drivers/debugger/debugger-download-tools">这里</a> 下载：</p>
<p><img src="https://www.pppp.ink/images/t2EWhPMraoTZmj8.png" alt="" /></p>
<p>目前，WinDbg 推出了 Preview 版本，改版本已经上架到了 Win10 应用商店。后文将使用 Preview 版本的 WinDbg 进行 Dump 文件的分析。</p>
<h2>蓝屏 Dump 文件的分析</h2>
<h3>符号文件设置</h3>
<p>从蓝屏状态恢复后，启动 WinDbg 工具，在进行调试之前，需要先为 WinDbg 设置符号文件地址</p>
<blockquote>
<p>如果想更有效的调试，你需要符号文件。符号文件可以是老式的COFF格式或者就是PDB格式。PDB就是程序数据库文件并且包含了公有符号。这些调试器内，你可以使用一系列的地址来让调试器寻找已经加载的二进制文件的符号。</p>
</blockquote>
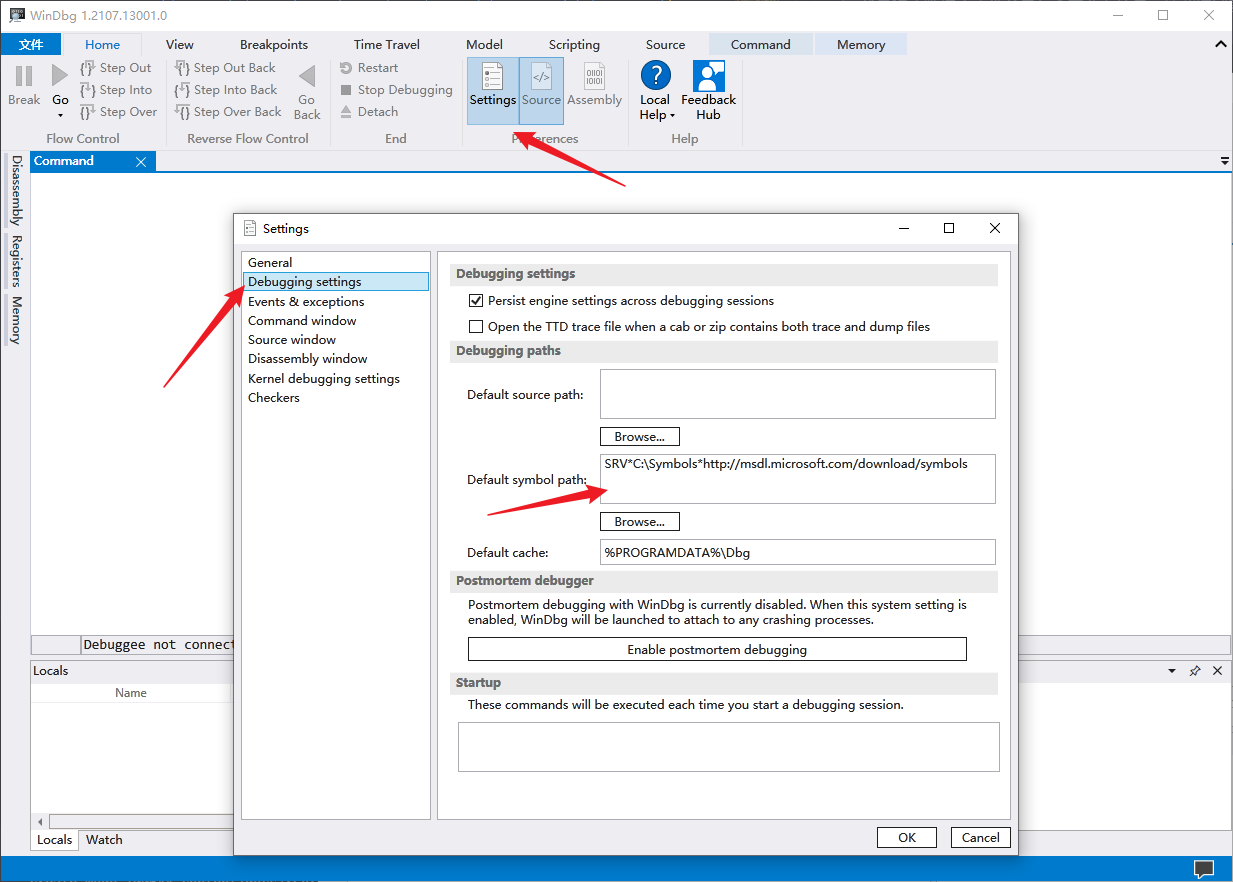
<p>操作系统的符号文件一般存储在 <code>%SYSTEMDIR%Symbols</code> 目录。驱动程序的符号文件(.DBG或.PDB)一般存储在和驱动文件(.sys 文件)相同的目录下。</p>
<p>为了更详细的分析，需要引入网络上的符号文件，因此，将 <code>.sympath</code> 设置为 <code>SRV*C:\Symbols*http://msdl.microsoft.com/download/symbols</code></p>
<p><img src="https://www.pppp.ink/images/sietgAwSEq2KIvb.png" alt="" /></p>
<h3>加载 Dump 文件</h3>
<p>打开目录 <code>C:\Windows\Minidump</code> 找到发生蓝屏时的 Dump 文件
由于权限问题，我们先把需要调试的文件复制到用户权限目录下，之后，使用 WinDbg 工具加载该 Dump 文件。</p>
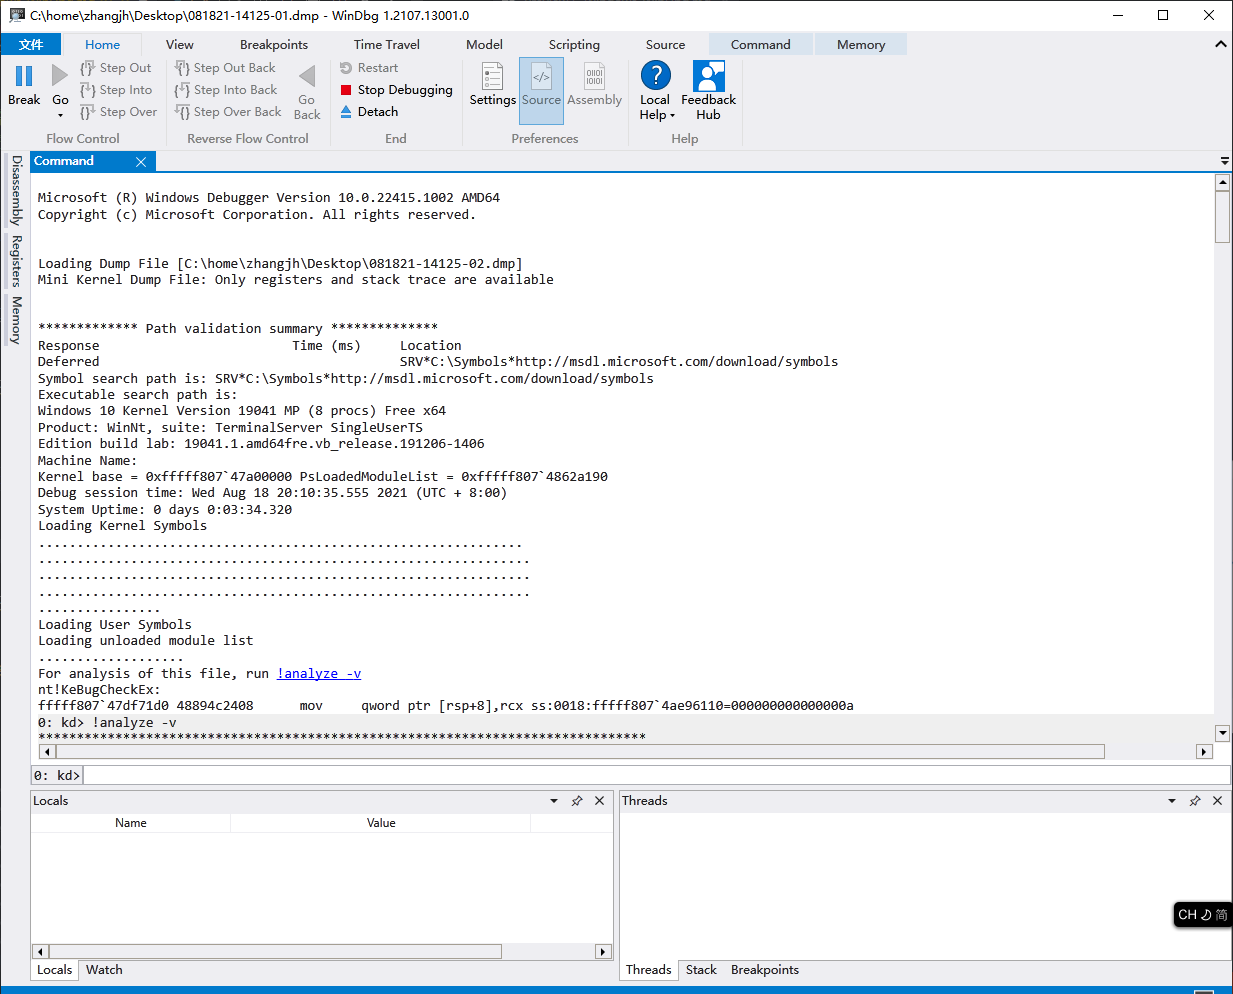
<p>第一次加载 Dump 文件时，WinDbg 会联网下载需要的符号文件，耐心等待。</p>
<p>当所需符号文件加载完毕后，会给出一个初步的诊断结果:</p>
<p><img src="https://www.pppp.ink/images/yUVWu4PcATHlvq2.png" alt="" /></p>
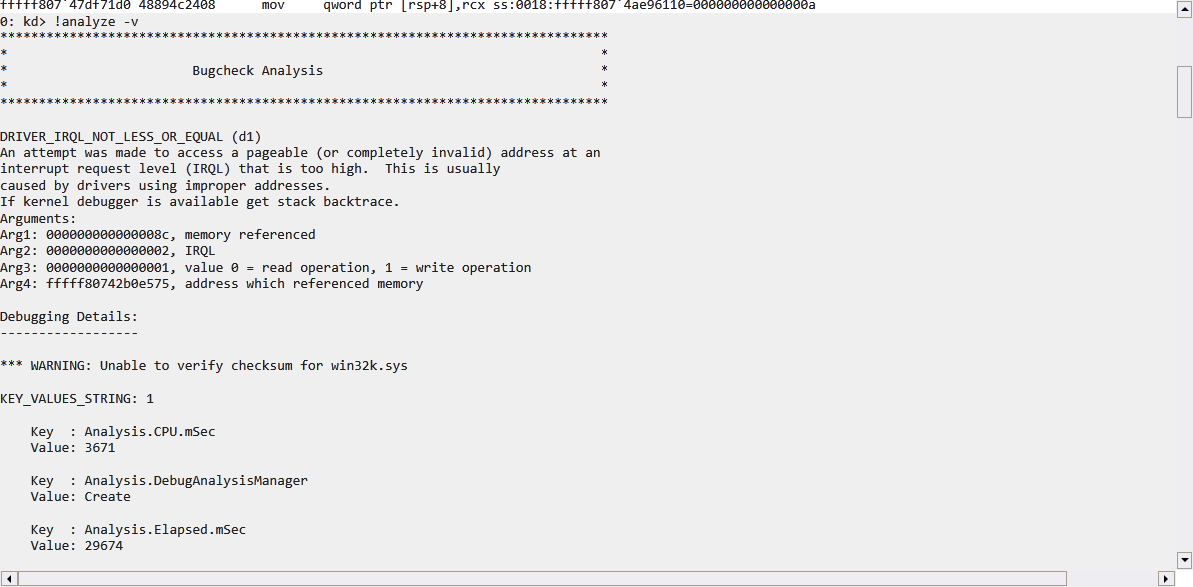
<p>结果中给出了引发崩溃的具体汇编代码，但对于定位问题几乎毫无帮助。这时，我们点击输出窗口中的蓝色 <code>!analyze -v</code> 链接，会触发详细信息输出。</p>
<p><img src="https://www.pppp.ink/images/OXcUeVaWSJjPE4s.png" alt="" /></p>
<p>首先工具会给出一个错误代码，在这里给出的是 <code>DRIVER_IRQL_NOT_LESS_OR_EQUAL (d1)</code>，并且在下方给出了该错误代码的具体说明：</p>
<pre><code>An attempt was made to access a pageable (or completely invalid) address at an
interrupt request level (IRQL) that is too high.  This is usually
caused by drivers using improper addresses.
</code></pre>
<p>这次蓝屏的具体原因由此找到，驱动程序尝试访问一个终端请求级别更高的内存地址，引发了内核的保护导致蓝屏。</p>
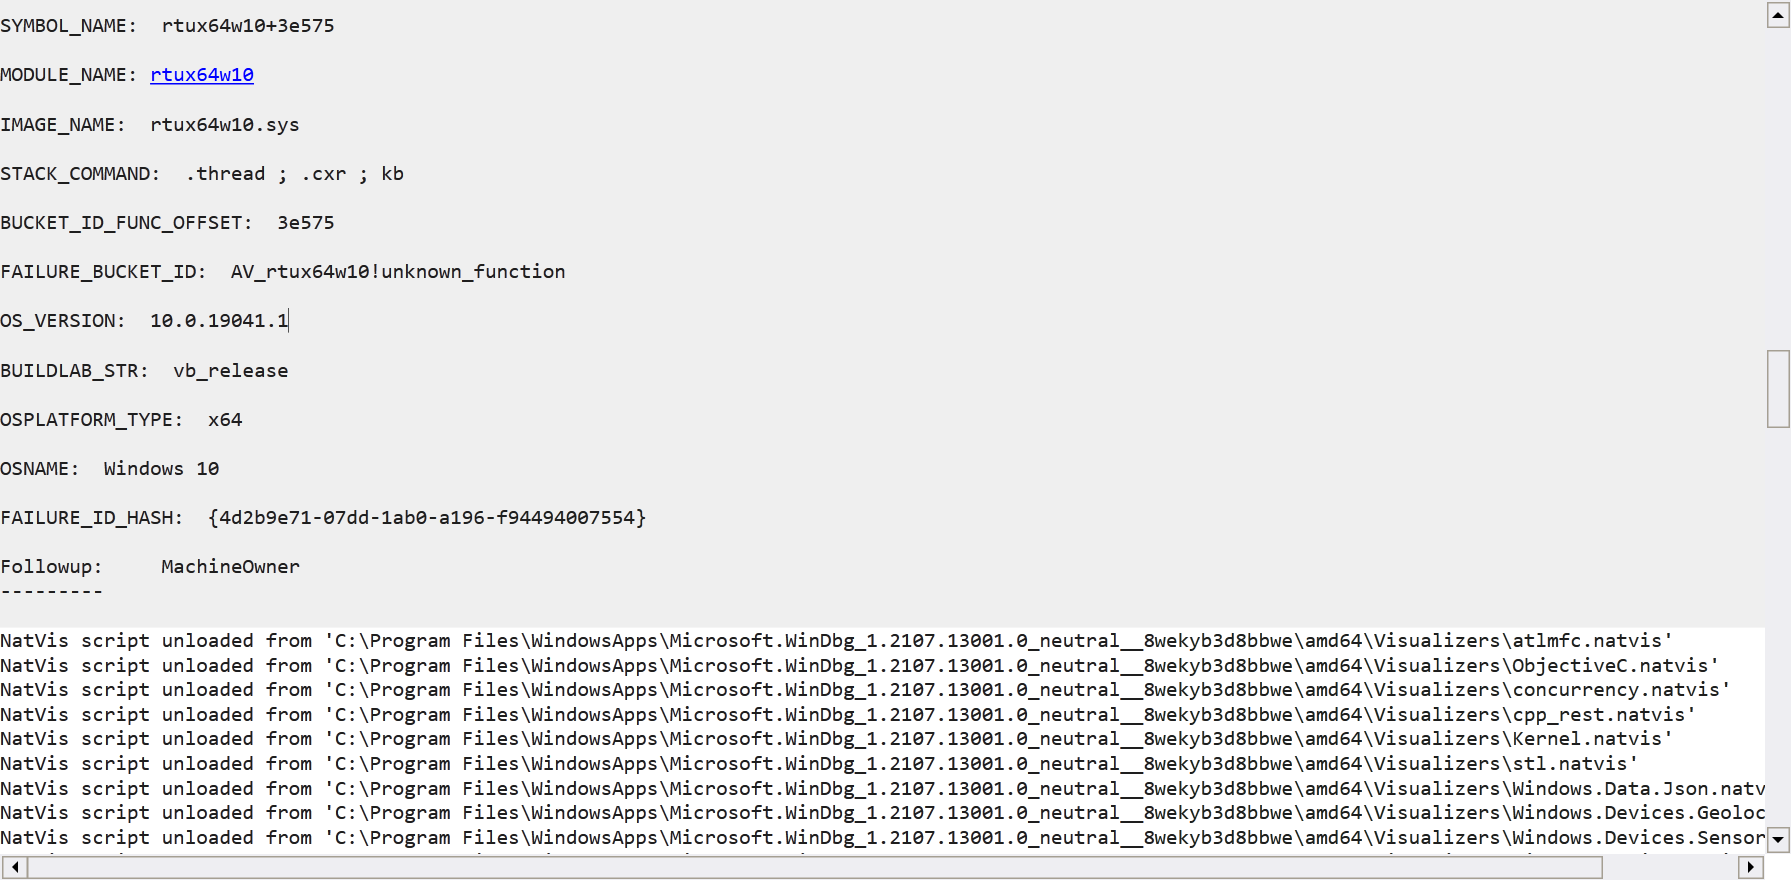
<p>具体的驱动程序是哪个呢？继续向下浏览，我们可以看到：</p>
<p><img src="https://www.pppp.ink/images/xjqWVuObK4drCIy.png" alt="" /></p>
<p>罪魁祸首找到了！正是 <code>rtux64w10</code> 这个内核模块。</p>
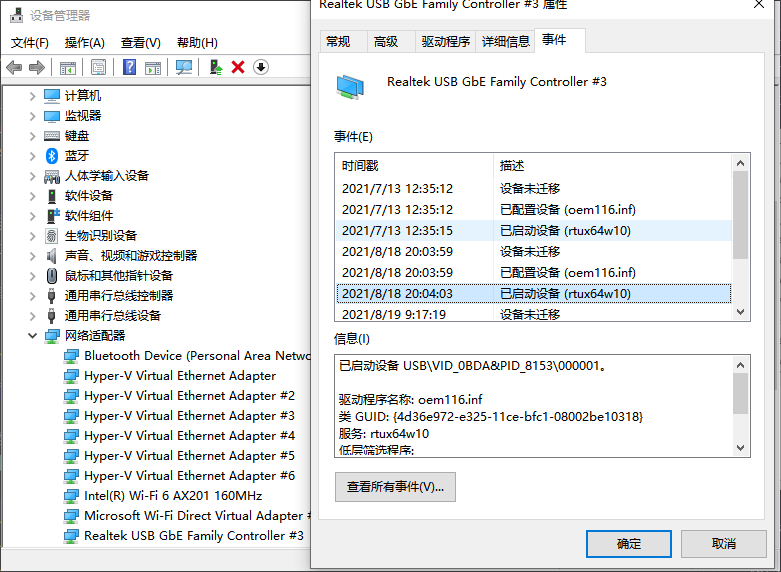
<p>该内核模块是 Realtek USB Ethernet Controller （USB无线网卡）的驱动程序。我们打开设备管理器再次确认：</p>
<p><img src="https://www.pppp.ink/images/KMdJos917L4DG3O.png" alt="" /></p>
<p>确凿无误了，正是有线网卡驱动引发的蓝屏问题，难怪蓝屏常常发生在下载文件的过程中。</p>
<p>前往 Realtek 官网下载最新版的网卡驱动解决问题： <a href="https://www.realtek.com/en/component/zoo/category/network-interface-controllers-10-100-1000m-gigabit-ethernet-usb-3-0-software">Realtek USB FE / GBE / 2.5G / Gaming Ethernet Family Controller Software</a></p>
<h2>后记</h2>
<h3>常见错误驱动程序名称对照表</h3>
<table>
<thead>
<tr>
<th><strong>错误驱动程序名称</strong></th>
<th><strong>对 应</strong></th>
<th><strong>修复方案</strong></th>
</tr>
</thead>
<tbody>
<tr>
<td>ntkrnlmp.exe</td>
<td>Windows 系统内核</td>
<td>通过官方渠道重新安装电脑所有主要硬件 (包括 BIOS、独立和核心显卡、有线和无线网卡、声卡等) 的驱动程序。</td>
</tr>
<tr>
<td>nvlddmkm.sys、dxgmms2.sys、igdkmd64.sys 等</td>
<td>电脑显卡硬件相关驱动程序</td>
<td>通过官方渠道重新安装独立显卡和核心显卡的硬件驱动程序。</td>
</tr>
<tr>
<td>NETIO.SYS、tcpip.sys、vwififlt.sys、wdiwifi.sys、rt640x64.sys 等</td>
<td>电脑网卡硬件相关驱动程序</td>
<td>通过官方渠道重新安装有线网卡和无线网卡的硬件驱动程序。</td>
</tr>
<tr>
<td>iaStorAC.sys</td>
<td>Intel 快速存储技术驱动程序</td>
<td>通过官方渠道重新安装 “Intel 快速存储技术” 驱动程序。</td>
</tr>
<tr>
<td>topsecpf.sys</td>
<td>“天融信” 厂商旗下应用程序</td>
<td>卸载电脑中的 “天融信” 厂商旗下软件。</td>
</tr>
<tr>
<td>360Hvm64.sys</td>
<td>360 安全卫士 (360 杀毒) 应用程序</td>
<td>卸载电脑中的 “360” 厂商旗下软件。</td>
</tr>
<tr>
<td>TesSafe.sys</td>
<td>腾讯电脑管家、腾讯游戏等应用程序</td>
<td>卸载电脑中的 “腾讯” 厂商旗下软件。</td>
</tr>
<tr>
<td>aida64.exe</td>
<td>“AIDA 64” 硬件检测工具</td>
<td>卸载电脑中的 AIDA 64 工具。</td>
</tr>
<tr>
<td>xlwfp.sys</td>
<td>“迅雷” 厂商旗下应用程序</td>
<td>卸载电脑中的 “迅雷” 厂商旗下软件。</td>
</tr>
<tr>
<td>chrome.exe</td>
<td>“谷歌” 旗下 Chrome 浏览器</td>
<td>卸载电脑中的 Google Chrome 浏览器。</td>
</tr>
</tbody>
</table>
<h3>《Windows 蓝屏通用修复方案操作指南》</h3>
<p><a href="https://answers.microsoft.com/zh-hans/windows/forum/all/windows-10/c19cca52-9b8f-44e3-abfa-fbea7db68f48">「Windows 10 | 技术文章」当电脑出现 “蓝屏” 异常问题时，应当如何处理？</a></p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-08-19T01:51:40.246Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[如何构建并且在 PyPi 发布你的 Python 库]]></title>
        <id>https://www.pppp.ink/blogs/6-python_packet.html</id>
        <link href="https://www.pppp.ink/blogs/6-python_packet.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[最近网盘项目需要一个通用编程接口，因此写了一个 Python 库对网盘操作进行封装：jcs-sdk，这里记录一下构建并发布一个 Python...]]></summary>
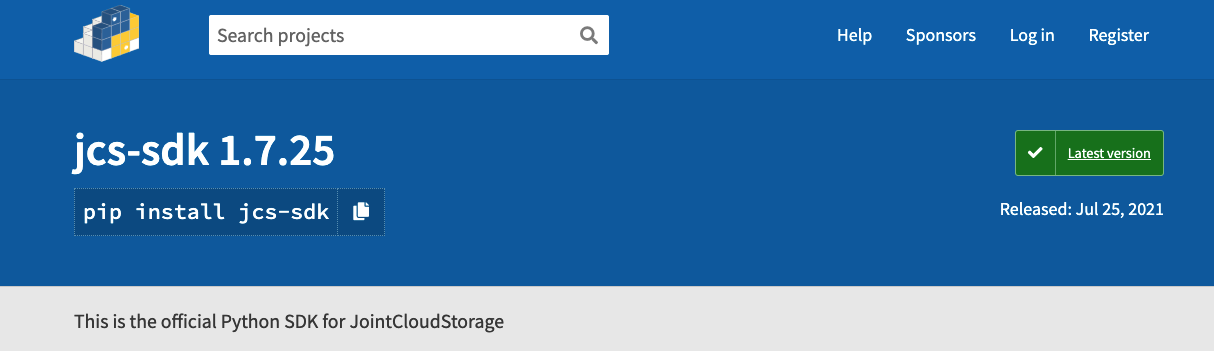
        <content type="html"><![CDATA[<p>最近网盘项目需要一个通用编程接口，因此写了一个 Python 库对网盘操作进行封装：<a href="https://pypi.org/project/jcs-sdk/">jcs-sdk</a>，这里记录一下构建并发布一个 Python 库的方法。</p>
<p><img src="https://www.pppp.ink/images/2021-07-27-1627356938-h7i6ra.png" alt="2021-07-27-1627356938-h7i6ra" /></p>
<h2>写一个 python 库</h2>
<h3>目录结构</h3>
<pre><code>.
├── JointCloudStorage # 存放所有的代码 目录名即为 python 库名
│   ├── __init__.py # 初始化文件，注意，一个 python 库必须要有这个文件
│   ├── auth.py
│   ├── bucket.py
│   ├── exceptions.py
│   └── state.py
├── README.md # 项目详细介绍
├── examples # 代码示例
│   ├── tmp
│   └── use.py
├── requirements.txt # 依赖包
├── setup.py # 项目构建脚本
├── tests # 代码测试
│   └── test_jsi_pytest.py
</code></pre>
<h3>模板代码</h3>
<p><code>__init__.py</code></p>
<pre><code>from JointCloudStorage.auth import *
from JointCloudStorage.bucket import *
from JointCloudStorage.state import *
</code></pre>
<ul>
<li><code>__init__.py</code> 该文件的作用就是相当于把自身整个文件夹当作一个包来管理，每当有外部import的时候，就会自动执行里面的函数。</li>
<li>通常使用该文件控制模块的导入，可以在 <code>__init__.py</code> 中指定默认导入的模块</li>
</ul>
<blockquote>
<p>有时候我们在做导入时会偷懒，将包中的所有内容导入</p>
<pre><code>from mypackage import *
</code></pre>
<p>这是怎么实现的呢？ <code>__all__</code> 变量就是干这个工作的。
<code>__all__</code> 关联了一个模块列表，当执行 from xx import * 时，就会导入列表中的模块。我们将 <code>__init__.py</code> 修改为 :</p>
<pre><code>__all__ = ['subpackage_1', 'subpackage_2']
</code></pre>
<p>这样就可以导入 <code>subpackage_1</code> 和 <code>subpackage_2</code> 模块了。</p>
</blockquote>
<p><code>setup.py</code></p>
<pre><code>from setuptools import find_namespace_packages, setup, find_packages

# 读取项目的readme介绍
with open("README.md", "r") as fh:
    long_description = fh.read()

setup(
    name="jcs-sdk",
    version="1.7.26",
    author="sincerexia",  # 项目作者
    author_email="zhangjh@act.buaa.edu.cn",
    description="This is the official Python SDK for JointCloudStorage",
    long_description=long_description, # 长介绍，直接读取 markdown 文件
    long_description_content_type="text/markdown",
    url="https://www.jointcloudstorage.cn",
    packages=find_packages(),
    python_requires="&gt;=3.6", # 该项目需要的python版本
    install_requires=[ # 依赖包
        "requests&gt;=2.26.0",
    ],
)
</code></pre>
<h2>发布</h2>
<pre><code>pip install twine
python setup.py develop
python setup.py sdist
python setup.py bdist_wheel
twine upload dist/*
</code></pre>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-07-27T03:04:03.946Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[VuePress favicon 配置]]></title>
        <id>https://www.pppp.ink/blogs/4-vuepress-favicon-pei-zhi.html</id>
        <link href="https://www.pppp.ink/blogs/4-vuepress-favicon-pei-zhi.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[推荐一个生成网站 favicon 的好工具：https://realfavicongenerator.net/ 该网站支持各个平台 favi...]]></summary>
        <content type="html"><![CDATA[<p>推荐一个生成网站 favicon 的好工具：<a href="https://realfavicongenerator.net/">https://realfavicongenerator.net/</a></p>
<h2>favicon 制作</h2>
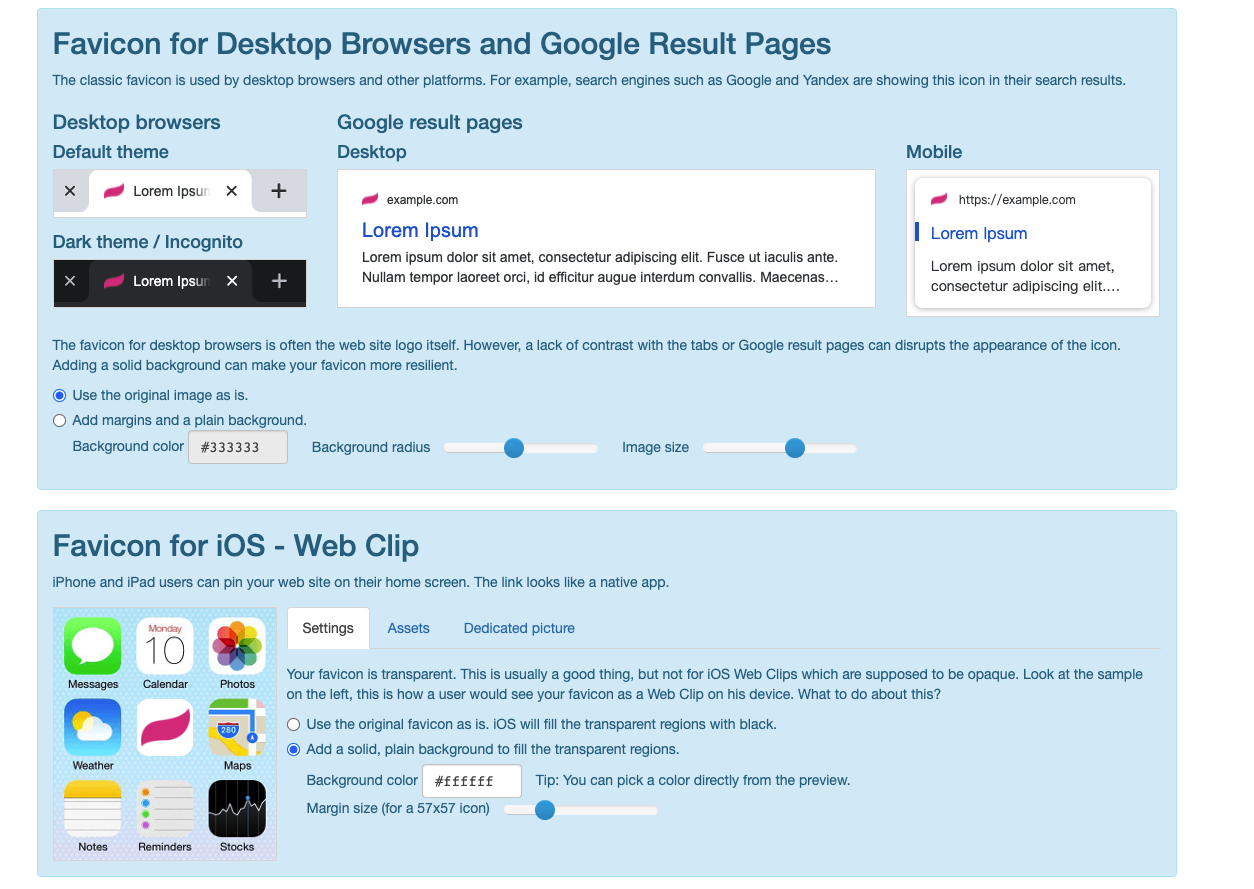
<p>该网站支持各个平台 favicon 的生成，甚至支持效果预览：</p>
<p><img src="https://www.pppp.ink/images/2021-07-07-1625662550-n14V0r.png" alt="2021-07-07-1625662550-n14V0r" /></p>
<p>对 favicon 的详细介绍可以看这里 <a href="https://www.zhangxinxu.com/wordpress/2019/06/html-favicon-size-ico-generator/">详细介绍HTML favicon尺寸 格式 制作等相关知识</a></p>
<h2>VuePress 如何使用</h2>
<p>使用该网站生成的 favicon 时，需要在网页的 <code>&lt;head&gt;</code> 中加入这些内容：</p>
<pre><code>&lt;link rel="apple-touch-icon" sizes="180x180" href="/apple-touch-icon.png"&gt;
&lt;link rel="icon" type="image/png" sizes="32x32" href="/favicon-32x32.png"&gt;
&lt;link rel="icon" type="image/png" sizes="16x16" href="/favicon-16x16.png"&gt;
&lt;link rel="manifest" href="/site.webmanifest"&gt;
&lt;link rel="mask-icon" href="/safari-pinned-tab.svg" color="#d55b98"&gt;
&lt;meta name="msapplication-TileColor" content="#da532c"&gt;
&lt;meta name="theme-color" content="#ffffff"&gt;
</code></pre>
<p>若使用 VuePress 搭建博客时，可以在 <code>config.js</code> 中加入以下内容：</p>
<pre><code>module.exports = {
  "head": [
    ['link', { rel: 'icon', href: '/logo.png' }],
    ['link', { rel: 'apple-touch-icon', href: '/apple-touch-icon.png' }],
    ['link', { rel: 'icon', type: 'image/png', href: '/favicon-32x32.png' }],
    ['link', { rel: 'icon', type: 'image/png', href: '/favicon-16x16.png' }],
    ['link', { rel: 'manifest', href: '/site.webmanifest' }],
    ['link', { rel: 'mask-icon', href: '/safari-pinned-tab.svg', color: "#d55b98"}],
    ['meta', { name: 'msapplication-TileColor', content: '#da532c'}],
    ['meta', { name: 'theme-color', content: '#ffffff'}],
    [
      "meta",
      {
        "name": "viewport",
        "content": "width=device-width,initial-scale=1,user-scalable=no"
      }
    ]
  ],
}
</code></pre>
<p>以上内容是本网站的 favicon 配置示例，请注意部分颜色值需要根据你自己的设定进行修改。</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-07-07T12:16:11.903Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[关于这个新博客]]></title>
        <id>https://www.pppp.ink/blogs/3-guan-yu-zhe-ge-xin-bo-ke.html</id>
        <link href="https://www.pppp.ink/blogs/3-guan-yu-zhe-ge-xin-bo-ke.html"/>
        <updated>2021-07-07T12:24:41.000Z</updated>
        <summary type="html"><![CDATA[总之，新的博客——粉墨 pppp.ink 它来了，希望我可以在这里一直一直写下去，我希望我能留下这一生的回忆，这毕竟是我存在的印记。当你看到...]]></summary>
        <content type="html"><![CDATA[<p>总之，新的博客——粉墨 <a href="http://pppp.ink">pppp.ink</a> 它来了，希望我可以在这里一直一直写下去，我希望我能留下这一生的回忆，这毕竟是我存在的印记。</p>
<p>当你看到这篇文章时，我的新博客可以说是搭建完毕了。新博客我将它取名为“粉墨”，域名是 <a href="http://pppp.ink">pppp.ink</a> 。目前，旧博客中的所有内容已经迁移到新服务器上并且不再更新，新的内容将会发布在这里。</p>
<h2>我为什么不在原来的博客上写文章了？</h2>
<p>原来的博客——夏末阁，是我在上高中时开始编写的博客，这么多年过去了，文章也没有几篇着实非常惭愧。之前的旧博客是使用 Typecho 搭建的，Typecho 类似 Wordpress，是基于 php 的动态博客程序。Typecho 与 Wordpress 相比，最突出的就是它真的非常简洁，提供的功能非常基础，但却也五脏俱全。然而，Typecho 已经好久好久不再更新了，感觉使用它的人也越来越少，各种插件无法使用，想要定制博客样式需要手写 php 代码。</p>
<p>原来的博客还有个严重的问题，就是评论系统几乎无法使用，我的旧博客貌似被刷网站SEO的人盯上了，在每篇文章下面刷各种垃圾评论，我不得不设置了所有评论人工审核，但每次一登录后台，就是几千+的垃圾评论需要处理，搞得毫无写文章的兴致。Typecho 的评论系统却连个验证码都无法设置。</p>
<p>关于文章内容，typecho 很难将一篇篇单独的文章合理组织成有体系的文档。写过的文章没有人读，自己也没有兴趣再回过头看，这就是写博客的热情满满磨灭的原因之一吧。</p>
<p>基于上面这些原因，最近一段时间，我用这个新的站点来记录那些我想要记录的东西。</p>
<h2>我的新博客</h2>
<p>目前，“粉墨”使用vuepress驱动构建，vuepress 可以在本地将 markdown 文件渲染成博客，这一过程在 Github 上的一个私有仓库里，由 Github Action 在每次 commit 后自动触发，将渲染好的文档同步推送到我的服务器上。</p>
<p>静态博客有个好处，就是完全不用担心服务器挂掉或者数据库挂掉神马的，而且直接在 vscode 中编写 md，然后 commit，也很符合码农的工作流程。博客的仓库托管在 gitlab 上，还能把我的 gitlab 日历变绿。不同的 md 文件可以通过目录结构有层次的组织起来，这也是我启用新博客的重要原因之一。</p>
<h2>这个新博客里会有什么东西？</h2>
<p>我想要在这里安安静静记录下生活中发生的事情，在这里说说心里想要说出的那些话，我知道在这里写下的东西大概没有什么人会看到，但这是我可以完全掌握的空间，可以随便胡乱写点什么而不会打扰到谁。</p>
<p>这里还会有我系（sui）统（yi）整理的一些文档，那些可能在以后有用的东西，可能需要时常查阅的东西，我也将他们放在这里，我希望他们能以文档的方式系统整理起来，希望他们或许能对一些人有帮助，至少能再帮助到我自己。</p>
<p>总之，新的博客——粉墨 <a href="http://pppp.ink">pppp.ink</a> 它来了，希望我可以在这里一直一直写下去，我希望我能留下这一生的回忆，这毕竟是我存在的印记。</p>
<p>我们每天每时每刻都有独一无二的经历，我们每天每时每刻都有酸甜苦辣的回忆，我们经历的过去构成了现在的自己，我从此将他们一一记录在这里。</p>
<p>人生若是能重来。</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-07-07T12:16:11.903Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Valine Admin 无限重定向问题解决方法]]></title>
        <id>https://www.pppp.ink/blogs/2-valine-adminchong-ding-xiang-wen-ti.html</id>
        <link href="https://www.pppp.ink/blogs/2-valine-adminchong-ding-xiang-wen-ti.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[部署好 Valine Admin 为什么无法进入后台，为什么总是重定向到 https 链接？真相只有一个！最近使用 Valine 评论系统...]]></summary>
        <content type="html"><![CDATA[<p>部署好 Valine Admin 为什么无法进入后台，为什么总是重定向到 https 链接？真相只有一个！</p>
<h2>起因</h2>
<p>最近使用 Valine 评论系统，发现不支持评论验证码和反垃圾功能，于是需要为 Valine 增加一个管理后台——<a href="https://github.com/DesertsP/Valine-Admin">Valine Admin</a></p>
<h2>问题描述</h2>
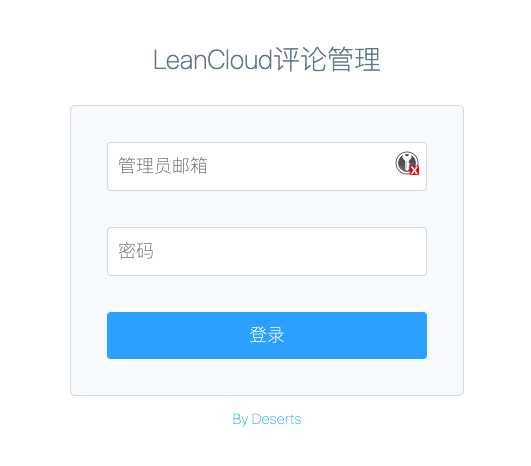
<p>但是，在部署过程中遇到了问题，按照 Valine Admin 在 Github Readme 中给出的部署方法在 LeanCloud 中进行部署，到达评论管理，设置管理员信息这一步时，遇到了无限重定向的问题。</p>
<blockquote>
<p><strong>评论管理</strong>
首先需要设置管理员信息。访问管理员注册页面 <a href="https://xn--9kqp7k2rd7vjkuh/sign-up">https://云引擎域名/sign-up</a>，注册管理员登录信息，如：<a href="https://deserts-io.avosapps.us/sign-up">https://deserts-io.avosapps.us/sign-up</a></p>
</blockquote>
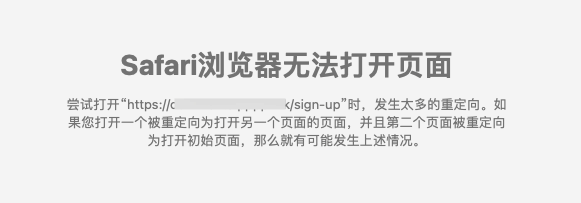
<p>问题表现如下：</p>
<p><img src="https://www.pppp.ink/images/2021-06-29-1624928829-iLfeUR.png" alt="2021-06-29-1624928829-iLfeUR" /></p>
<p>当访问 Valine Admin 后台时，不断重定向到 https 协议访问链接，即使是使用 https 协议直接访问也是如此。</p>
<p>搜索全网，似乎只有<a href="https://reinness.com/views/technology-sharing/vuepress/#%E5%AE%8C%E7%BB%93%E6%92%92%E8%8A%B1">这位老哥</a>遇到了和我一样的问题：
<img src="https://www.pppp.ink/images/2021-06-29-1624929439-8jdkeT.png" alt="2021-06-29-1624929439-8jdkeT" /></p>
<h2>原因排查</h2>
<p>在多次确认我的部署方案以及变量配置无误的情况下，搜索全网似乎没有解决方案，不得已浏览作者源码排查问题，发现在 <code>app.js</code> 文件中出现了这样一段代码：</p>
<pre><code>app.enable('trust proxy');
// 需要重定向到 HTTPS 可去除下一行的注释。
app.use(AV.Cloud.HttpsRedirect());
</code></pre>
<p>这段代码没有判断当前客户端是否在使用 https 协议访问，而是将所有请求直接通过 <code>AV.Cloud.HttpsRedirect()</code> 重定向到 https，但好像其他人之前很少遇到过无限重定向的问题。</p>
<p>推测可能是因为 LeanCloud 对这个方法的行为进行了修改，不再自动对用户协议进行判断，而要开发者手动判断是否正在使用 https 协议访问。LeanCloud 官方文档中有这样的说明：</p>
<blockquote>
<p><strong>如何判断请求是通过 HTTPS 还是 HTTP 访问的？</strong>
因为 HTTPS 加密是在负载均衡层面处理的，所以通常部署在云引擎上的 web 框架获取的请求 URL 总是使用 HTTP 协议，建议通过 X-Forwarded-Proto HTTP 头来判断原请求是通过 HTTP 还是 HTTPS 访问的。</p>
</blockquote>
<h2>解决办法</h2>
<p>修改 <code>app.js</code> 27 到 29 行，注释掉 <code>HttpsRedirect()</code> 如下：</p>
<pre><code>app.enable('trust proxy');
// 需要重定向到 HTTPS 可去除下一行的注释。
// app.use(AV.Cloud.HttpsRedirect());
</code></pre>
<p>你可以从 <code>DesertsP/Valine-Admin</code> 仓库中 fork 一份进行修改，也可以在一键部署时，直接使用我修改好的 git 仓库：<code>https://github.com/SincereXIA/Valine-Admin.git</code></p>
<p>重新部署之后，问题解决：</p>
<p><img src="https://www.pppp.ink/images/2021-06-29-1624929827-VAE3xw.png" alt="2021-06-29-1624929827-VAE3xw" /></p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-29T00:59:48.537Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[北航计算机学院 研究生 算法考试复习资料]]></title>
        <id>https://www.pppp.ink/docs/buaa/1-suan-fa.html</id>
        <link href="https://www.pppp.ink/docs/buaa/1-suan-fa.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[不用再找了，这就是全网最全的北航算法复习资料 贪婪技术所做的每一步选择所产生的部分解，不一定是可行性的 :x: 贪婪技术的核心：所做的每一步...]]></summary>
        <content type="html"><![CDATA[<p>不用再找了，这就是全网最全的北航算法复习资料</p>
<h2>判断题</h2>
<ol>
<li>
<p>贪婪技术所做的每一步选择所产生的部分解，不一定是可行性的</p>
<p>:x: 贪婪技术的核心：所做的每一步选择都必须满足：(1) 可行的，即它必须满足问题的约束； (2) 局部最优，即它是当前步骤中所有可行性选择中最佳的局部选择；(2) 不可取消，即一旦做出，在算法的后续步骤就无法改变了。</p>
</li>
<li>
<p>一个正确的算法，对于每一个合法输入，都会在有限时间内输出一个满足要求的结。</p>
<p>:white_check_mark:</p>
</li>
<li>
<p>动态规划中，各阶段所确定的<s>策略</s>就构成一个策略序列，通常称为一个决策</p>
<p>:x: 决策和策略：决策是指某阶段状态给定以后，从该状态演变到下一个阶段某状态的选择；<strong>由每段的决策组成的决策函数序列就称为全过程策略，简称策略。</strong></p>
</li>
<li>
<p>通常来说，算法的最坏情况的时间复杂性比平均情况的时间复杂性容易计算</p>
<p>:white_check_mark:</p>
</li>
<li>
<p>回溯法用深度优先法搜索状态空间树</p>
<p>:white_check_mark: 针对所要做的选择构造一棵所谓的状态空间树，树的每一层节点代表了对解的每一个分量所做的选择；用DFS（深度优先法）搜索状态空间树；在状态空间树中的任一个节点，满足一定条件的情况下，搜索回溯。</p>
</li>
<li>
<p>快排算法的平均时间复杂度是 O(nlogn), 使用随机化快排算法可以将平均时间复杂度降得更低</p>
<p>:x: 平均时间复杂度不会降低，只会降低最坏情况出现的概率。最坏情况出现在随机数生成结果恰好使数组有序----概率极小。</p>
</li>
<li>
<p>P 类问题和 NP 类问题的关系用 $p\subset NP$ 来表示是错误的</p>
<p>:x: P 中所有问题都属于 NP</p>
<p><img src="https://www.pppp.ink/images/2021-01-0720151015164207766qvmWuU.jpeg" alt="img" /></p>
</li>
<li>
<p>NP 完全问题比其他所有 NP 问题都要难</p>
<p>:x: NP 完全问题至少同其他所有 NP 问题<strong>一样难</strong>，NP-hard 问题：比 NP 问题都要难的问题</p>
<p>https://zhuanlan.zhihu.com/p/73953567</p>
<ul>
<li>
<p><strong>P类问题</strong>：存在多项式时间算法的问题。(P：polynominal，多项式)。</p>
</li>
<li>
<p><strong>NP问题</strong>：能在多项式时间内验证得出一个正确解的问题。(NP:Nondeterministic polynominal，非确定性多项式)。</p>
</li>
<li>
<p><strong>NPC类问题</strong>（Nondeterminism Polynomial complete）：存在这样一个NP问题，所有的NP问题都可以约化成它。换句话说，只要解决了这个问题，那么所有的NP问题都解决了。其定义要满足2个条件：</p>
<ul>
<li>首先，它得是一个NP问题；</li>
<li>所有的NP问题都可以约化到它。</li>
<li>要证明npc问题的思路就是： 先证明它至少是一个NP问题，再证明其中一个已知的NPC问题能约化到它。</li>
</ul>
</li>
<li>
<p><strong>NP难问题</strong>（NP-hard问题）：</p>
<p>NP-Hard问题是这样一种问题，它满足NPC问题定义的第二条但不一定要满足第一条（就是说，NP-Hard问题要比 NPC问题的范围广，NP-Hard问题没有限定属于NP），即所有的NP问题都能约化到它，但是它不一定是一个NP问题。</p>
</li>
</ul>
</li>
<li>
<p>若 P2 多项式时间转化为 P1，则 P2至少与 P1 一样难</p>
<p>:x: P2 不会比 P1 难，P1 至少与 P2 一样难。</p>
</li>
<li>
<p>一个完全多项式近似方案是一个近似方案 {A, } 其中每一个算法 A，在输入实例 I 的规模的多项式时间内运行。</p>
<p>:x: 一个多项式近似方案(PAS)是一个近似方案{AƐ},其中每一个算法AƐ 在输入实例I的规模的多项式时间内运行;一个完全多项式近似方案(FPAS)是一个近似方案{AƐ},其中每个算法 AƐ在以输入实例的规模和1/Ɛ两者的多项式时间内运行</p>
<p>http://home.ustc.edu.cn/~huang83/turing/alg5.pdf</p>
<ul>
<li>近似方案：设$\pi$是目标函数为݂$f_\pi$的NP-hard最优化问题，如果关于输入$(I,\varepsilon)$，$I$ 为$\pi$的实例，$\varepsilon$ 为误差参数，算法$A$输出解ܵ使得：（最小化问题）$f_\pi(I,S)\le(1+\varepsilon)*OPT$ 称$A$ 是 $\pi$ 的近似方案</li>
<li>PTAS (Polynomial-Time Approximation Scheme )  若对于每一个固定的$\varepsilon$，算法的运行时间以实例$I$的规模的多项 式为上界，则$A$是一个多项式时间近似方案(简称PTAS)。</li>
<li>FPTAS 在PTAS的基础上，我们进一步要求算法，即算法A的运行时间以 实例$I$的规模和$1/\varepsilon$ 的多项式为上界，则称$A$是一个完全多项式时间近似方案(简称FPTAS)。<strong>近似算法的复杂度和精度要求有关</strong></li>
</ul>
</li>
<li>
<p>基于比较的寻找数组 A[1...n] 中最大值元素问题的下界是 $\Omega(n/3)$</p>
<p>:x: 只寻找最大值，下界是 O(n-1) ，同时寻找最大值和最小值，下界是 $O(3n/2)$，</p>
<blockquote>
<p>首先两两比较，分成A组与a组，每组n个，此时用了n次。A组内取最大，用n-1次，a取最小也是n-1次。一共n+(n-1)*2</p>
</blockquote>
</li>
<li>
<p>Las Vegas 算法只要给出解就是正确的</p>
<p>:white_check_mark: Las Vegas 算法总是要么给出正确的解，要么告知无解</p>
<blockquote>
<p><strong>拉斯维加斯算法 (Las Vegas)</strong> 是另一种随机算法，因此它具备随机算法最为重要的特征之一 —— <strong>基于随机数进行求解</strong>。与 <a href="https://zhuanlan.zhihu.com/p/80629756">蒙特卡洛算法 (Monte Carlo)</a> 一样，拉斯维加斯算法也不是一种具体的算法，而是一种思想。但不同的是，拉斯维加斯算法在生成随机值的环节中，会不断的进行尝试，直到生成的随机值令自己满意。在这过程中也许会一直无法产生这样的随机值，因此拉斯维加斯算法的时间效率通常比蒙特卡洛算法来的低，并且最终可能无法得到问题的解，但是一旦算法找到一个解，那么这个解一定是问题的正确解。</p>
</blockquote>
<p>**拉斯维加斯算法不赌结果的正确性，而是赌运算所用资源。**一个简单的例子是随机<a href="https://zh.wikipedia.org/wiki/%E5%BF%AB%E9%80%9F%E6%8E%92%E5%BA%8F">快速排序</a>，他的中心点虽然是随机选择的，但排序结果永远一致。</p>
</li>
<li>
<p>若近似算法 A 求解某极小化问题一实例的解为 $s_a$ ，且已知该问题的最优解为 $s_a/3$ 则该近似算法的性能比为 3</p>
<p>:x: 不能只看某一实例的解，应该要寻找问题所有实例的上界</p>
</li>
<li>
<p>$O(f(n))+O(g(n)) = O(min{f(n), g(n)})$</p>
<p>:x: $O(f(n))+O(g(n)) = O(max{f(n), g(n)})$</p>
</li>
<li>
<p>$\Theta(f(n)+g(n)) = \Theta (max(f(n),g(n)))$</p>
<p>:white_check_mark:</p>
</li>
<li>
<p>若 $f(n)=\Omega(g(n))$, $g(n) = \Omega(h(n))$ 则 $f(n)=\Omega(h(n))$</p>
<p>:white_check_mark:</p>
</li>
</ol>
<p>$$
\begin{array}{l}
O(f(n))+O(g(n))=O(\max {f(n), g(n)}) \
O(f(n))+O(g(n))=O(f(n)+g(n)) \cdot \
O(f(n))^{<em>} O(g(n))=O\left(f(n)^{</em>} g(n)\right) \
O(c f(n))=O(f(n)) \
f(n)=O(g(n)), \quad g(n)=O (h(n)) \Rightarrow  f(n)=O (h(n)) \
f(n)=\Omega(g(n)), \quad g(n)=\Omega(h(n)) \Rightarrow  f(n)=\Omega(h(n)) ; \
f(n)=\Theta(g(n)), \quad g(n)=\Theta(h(n))  \Rightarrow  f(n)=\Theta(h(n)) ;
\end{array}
$$</p>
<p>$$
\begin{array}{l}
f(n)=\Theta(g(n)) \Leftrightarrow g(n)=\Theta (f(n)) \
f(n)=O(g(n)) \Leftrightarrow g(n)=\Omega(f(n)) \
f(n)=\Theta(f(n)) \
f(n)=O(f(n)) \
f(n)=\Omega(f(n))
\end{array}
$$</p>
<ol>
<li>
<p>若$f(n)=O(g(n))$, 则 $g(n)=\Omega(f(n))$</p>
<p>:white_check_mark: Ο是渐进上界，Ω是渐进下界。Θ需同时满足大Ο和Ω，故称为确界（必须同时符合上界和下界）。</p>
</li>
<li>
<p>NP 完备（NP-Complete）问题是所有 NP 问题中最难的，目前还没 有找到用于解决 NP 完备问题的多项式算法。</p>
<p>:x:</p>
</li>
<li>
<p>已知团问题（Clique problem）为NP问题，那么下列问题是一个判定问题：给定一个图G，求G中最大团的尺寸（size）K。</p>
<p>:x:</p>
</li>
<li>
<p>随机化快速排序的worst case 出现于输入数组恰好为已按非降序排列的情况（假设输出的排序结果也要求是非降序）。</p>
<p>:x:</p>
</li>
<li>
<p>动态规划算法通过增加空间复杂性来降低时间复杂性。</p>
<p>:white_check_mark:</p>
</li>
<li>
<p>回溯法用深度优先或广度优先法搜索状态空间树。</p>
<p>:x:</p>
</li>
<li>
<p>若求解问题p的一个算法A的复杂性为f(n) ，则p的复杂性C(p)小于等于f(n)。</p>
<p>:white_check_mark:</p>
</li>
<li>
<p>所有问题当中最难的一组问题被称为NP完备 (NP-Complete) 问题。</p>
<p>:x:</p>
</li>
</ol>
<h2>简答题</h2>
<ol>
<li>
<p>二叉查找树属于减治策略的三个变种中哪一个的应用？什么情况下二叉查找树表现出最差的效率？此时的查找和插入算法的复杂性如何？</p>
<ol>
<li>
<p>二叉查找树属于减可变规模变种的应用</p>
<blockquote>
<p>减治策略的三个变种： 减常量、减常数因子、减可变规模</p>
<ul>
<li>减去一个常量(a constant) <strong>DFS，BFS</strong></li>
<li>减去一个常数因子(a constant factor) <strong>折半查找</strong></li>
<li>减去的规模是可变的(variable size desrease) <strong>二分查找</strong></li>
</ul>
</blockquote>
</li>
<li>
<p>表现出最差的效率：当先后插入的关键字有序时，构成的二叉树变为单枝树，树的深度为 n ，此时二叉查找树表现出最差的效率</p>
</li>
<li>
<p>此时查找和插入算法的时间复杂度都为 O(n)</p>
</li>
</ol>
</li>
<li>
<p>构造 AVL 树和 2-3 树的主要目的是什么？他们各自有什么样的查找和插入的效率</p>
<ol>
<li>主要目的：一棵AVL树要求它的每个节点的左右子树的高度差不能超过1。2-3树和2-3-4树允许一棵查找树的单个节点不止包含一个元素。构造 AVL 树和 2-3 树，可以使先后插入的关键字有序时，使树的深度减少</li>
<li>查找和插入效率：AVL 树，插入和查找效率为 O(logn)，2-3 树的查找和插入效率属于 O(logn)</li>
</ol>
</li>
<li>
<p>写出 01 背包的一个多项式等价的判定问题，并说明为什么他们是多项式等价的</p>
<blockquote>
<p>0/1背包问题：从M件物品中，取出若干件放在空间为W的背包里，给出一个能获得最大价值的方案。每件物品的体积为W1，W2……Wn，与之相对应的价值为P1,P2……Pn。</p>
</blockquote>
<ul>
<li>判定问题I：从M件物品中，取出若干件放在空间为W的背包里，是否存在一个方案，所获价值≥P*？。每件物品的体积为W1，W2……Wn，与之相对应的价值为P1,P2……Pn。</li>
<li>对于判定问题P，以及输入N, w, v, W, V：构造对应的背包问题P0，求出P的最大价值和V0，与问题P的输入V进行比较即可判定是否存在，即 P 规约到 P0
对于背包问题 P0，在0和所有元素的价值总和Vmax之间进行二分，每次构造判定问题P，即可求得P0的解。即 P0 规约到 P。因此他们是多项式等价的</li>
</ul>
</li>
<li>
<p>何谓伪多项式算法？如何将一 Monte Carlo 算法转化为 Las Vegas 算法</p>
<ul>
<li>
<p>伪多项式时间算法是一种算法，它在 L 值的多项式时间内运行，其中 L 是输入实例中的最大数值</p>
<blockquote>
<p>算法的复杂度与输入规模呈指数关系，与输入的数值大小呈多项式关系。</p>
</blockquote>
</li>
<li>
<p>Las Vegas算法不会得到不正确的解。一旦用拉斯维加斯算法找到一个解，这个解就一定是正确解。但有时用拉斯维加斯算法找不到解。</p>
<p>Monte Carlo算法每次都能得到问题的解，但不保证所得解的准确性</p>
<p>转化：可以在Monte Carlo算法给出的解上加一个验证算法，如果正确就得到解，如果错误就不能生成问题的解，这样Monte Carlo算法便转化为了Las Vegas算法。</p>
</li>
</ul>
</li>
<li>
<p>以子集和问题为例说明伪多项式时间算法和FPAS可以有的关系。</p>
<ul>
<li>时间复杂度表示为输入数据数值规模N的多项式，但是运行时间却与N的二进制成指数关系，这样的时间复杂度的算法称为伪多项式时间的算法。</li>
<li>FPTAS 在PTAS的基础上，我们进一步要求算法，即算法A的运行时间以 实例$I$的规模和$1/\varepsilon$ 的多项式为上界，则称$A$是一个完全多项式时间近似方案(简称FPTAS)。<strong>近似算法的复杂度和精度要求有关</strong></li>
<li>为NP难问题找到一个FPAS的想法对存在伪多项式时间算法的问题来说是很典型的。可以对实例 I 的输入值应用尺度变换和舍入得到实例 I' 并解之</li>
<li>对于子集和问题，算法的近似度是$1+\varepsilon$ ，运行时间是$\Theta (n^2/\varepsilon)$</li>
</ul>
</li>
<li>
<p>下面的问题是否属于 NP 问题？为什么？</p>
<p>给定图 G=(N,A) 中的两个点 p、q，整数 c 和 t，图 G 中每条边的长度 cij 及便利这条边的时间 tij。问图 G 中是否存在一条由 p 到 q 的路径，使得其长度大于 C，且遍历时间小于 t？</p>
<ul>
<li>这个问题属于 NP 问题（多项式时间内验证解）。因为若给出该问题的一个解，可以在多项式时间内验证这个解的正确性。如给出一条由 p 到 q 的路径，可以在多项式时间内计算出它的长度和遍历这条路径的时间，然后分别于 C 和 t 进行比较，从而可以判断出这个解的对错</li>
</ul>
</li>
<li>
<p>请给出基于比较的对数组 A[1…n]进行排序问题的最紧的下界，并写出两个 平均时间复杂度为该下界的排序算法的名称。</p>
<ul>
<li>下界为 $O(nlogn)$</li>
<li>快排，归并排序</li>
</ul>
</li>
<li>
<p>请举出三种寻找问题下界的方法或策略</p>
<p>寻找下界的策略：</p>
<ul>
<li>平凡下界：对问题的输入中必须要处理的项及必须要输出的项进行计数</li>
<li>信息量论证</li>
<li>对手规约</li>
<li>问题规约</li>
</ul>
</li>
<li>
<p>说一个有最优解的贪心算法？</p>
<ul>
<li>最短路径、Dijstra、哈夫曼编码</li>
</ul>
</li>
<li>
<p>​    推导以下递推式的解：</p>
<p>T(n)=2          当n=3时</p>
<p>T(n)=2T(n/3)+2n    当n&gt;3时</p>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188239-2021-01-11image-20210111100008043kt9pKO.png" alt="image-20210111100008043" /></p>
</li>
<li>
<p>求解TSP问题的最近邻居算法的性能比是多少？这一性能比是如何求得的？</p>
<p>最近邻居算法：基于一种最近邻居的直观推断：下一次总是访问最近的未访问城市</p>
<p>第一步：任意选择一个城市作为起点    第二步：重复下面的操作直到访问完所有的城市：访问和最近一次访问的城市 k 最接近的未访问城市（如 果有距离相同的城市，可任意选择其一） 第三步：回到起点城市</p>
<p>性能比：</p>
<p>$$
\frac{m\left(x, s_{a}\right)}{m *(x)} \leq \frac{1}{2}\left(\left\lceil\log _{2} n\right\rceil+1\right)
$$</p>
<p>这一性能比是在欧几里得类型 TSP 问题约束下求得的</p>
</li>
<li>
<p>请给出基于比较的寻找数组A[1…n]中最大和最小元素问题的最紧的下界，并说明这个下界是用了课上介绍的哪种或哪几种寻找问题下界的策略得来的。</p>
<ul>
<li>
<p>寻找下界的策略：</p>
<ul>
<li>平凡下界：对问题的输入中必须要处理的项及必须要输出的项进行计数</li>
<li>信息量论证</li>
<li>对手规约</li>
<li>问题规约</li>
</ul>
</li>
<li>
<p>使用 3n/2-2次比较可计算最大值与最小值</p>
<p>算法初始把所有元素标记为N，且算法运行过程中必须标 记n-1次W和n-1次L，因此至少需要2n-2 “信息单位” 。 每次比较中能得到的最大信息量为2，且只当比较两个标记为N的 元素时产生。但此种情况最多产生 n/2次，共n个信息单位 。 除此以外的其他比较最多产生1个信息量，因此对于剩下的n-2个 信息量，最坏情况下需要 n-2次比较。</p>
</li>
<li>
<p>运用了对手规约的方法得来的</p>
</li>
</ul>
</li>
<li>
<p>请给出寻找数组A[1…n]中是否有大于0的元素问题的最紧的下界，并说明这个下界是用了课上介绍的哪种或哪几种寻找问题下界的策略得来的。</p>
<p>下界是 n，使用平凡下界的策略得来</p>
</li>
<li>
<p>是否存在具有最小绝对差界的求解地图着色问题的近似算法？若有，请写出伪代码，并说明为什么其绝对差界已达最小。</p>
</li>
<li>
<p><img src="https://www.pppp.ink/images/2021-01-08image-20210108173024037ce36XE.png" alt="image-20210108173024037" /></p>
</li>
<li>
<p>用对手论证法给出最坏情况下，从n个数字中找第二小值的基于比较的算法的下界；这个下界是紧密的吗</p>
<p>算法的下界是：$n+\lceil \log n \rceil -2$</p>
<p>每次两两进行配对，利用淘汰赛求得最大值max（n-1次比较）；然后从所有与max进行比较输了的元素中找到最大值（log2n-1次 比较）</p>
<p>这个下界是紧密的</p>
</li>
<li>
<p>在最坏情况下，任意一个基于比较的算法从n个 元素（假设n为偶数）中确定最大值和最小值至少需要 (3n/2)-2 次比较。</p>
<p>证明：算法初始把所有元素标记为N，且算法运行过程中必须标 记n-1次W和n-1次L，因此至少需要2n-2 “信息单位” 。 每次比较中能得到的最大信息量为2，且只当比较两个标记为N的 元素时产生。但此种情况最多产生 n/2次，共n个信息单位 。 除此以外的其他比较最多产生1个信息量，因此对于剩下的n-2个 信息量，最坏情况下需要 n-2次比较。 因此，最坏情况下，至少需要 n/2 + n-2 =3n/2 – 2次比较。</p>
</li>
<li>
<p><strong>请分别阐述邻域搜索、模拟退火与遗传算法的基本原理，并从算法特点与计算效果等角度比较它们的异同</strong></p>
<p>遗传算法：</p>
<ul>
<li>
<p>基本原理：遗传算法是一种基于群体寻优的方法， 算法运行是以一个种群在搜索空间进行搜索，根据具体问题构造恰当适值函数，根据适应值的大小不断选择和繁殖</p>
</li>
<li>
<p>特点：</p>
<ul>
<li>同时处理群体中的多个个体，减少了陷入局部最优解的风险，算法本身易于并行化</li>
</ul>
</li>
</ul>
<p>邻域搜索：</p>
<ul>
<li>基本原理：基于贪婪思想, 持续地在当前解的邻域中搜索, 直至 邻域中再也没有更好的解, 也称为爬山启发式算法</li>
<li>特点：
<ul>
<li>易理解易实现, 具有很好的通用性,</li>
<li>但搜索结果完全依赖于初始解和邻域的结构 ，只能搜到局部最优</li>
</ul>
</li>
</ul>
<p>模拟退火：</p>
<ul>
<li>模拟热力学中退火过程能使金属原子达到能量最低状态的 机制， 通过模拟的降温过程按波尔兹曼方程计算状态间的 转移概率来引导搜索，</li>
<li>特点：
<ul>
<li>具备良好的全局搜索能力，最终解逼近全局最优解，对初始解的依赖较低</li>
</ul>
</li>
</ul>
</li>
<li>
<p>说明最小生成树的Prim算法不具有拟阵的结构，即说明Prim算法所对应的二元组 M=(S,I)不满足遗传性质或不满足交换性质。</p>
<blockquote>
<p>拟阵是一个满足如下条件的有序对：M=(S,I)</p>
<ul>
<li>S 是非空有限集</li>
<li>I 是 S 子集的一个非空族，这些子集称为 S 的独立子集，I 满足遗传性质，若 $B \in I$, 且 $A \subseteq B$, 则 $A\in I$
<ul>
<li>若 B 是 S 的独立子集，则 B 的任意子集均是 S 的独立子集</li>
</ul>
</li>
<li>I 满足 交换性质，若 $A\in I$ , $B\in I$ 且 $|A|&lt;|B|$ 则存在某个元素 $x\in B-A $ 使得 $A \cup {x} \in I$</li>
</ul>
</blockquote>
<ul>
<li>对于给定的无向图 G=(V,E) 定义$S_G$ 为图的边集 E</li>
<li>由于Prim 算法的每一步，均生成 V 的子集的最小生成树， $I_G$ 是最小生成树边集的非空族，即 $I_G$ 中的每一个集合均构成 V 中部分顶点的最小生成树</li>
<li>$I_G$ 不满足遗传性质，最小生成树边集的子集不一定构成最小生成树，最小生成树边集的子集可能只是一个森林</li>
</ul>
</li>
<li>
<p>分支定界算法遍历搜索树的“Frontier Search”，是如何工作的？为什么会有这样一种方法？（本题 3 分）</p>
<ul>
<li>在构造二叉树时，将分支按照一定的规则进行排序，可以使得解树向左偏，即最优解更可能出现在左分支上。使得 Frontier Search 能够更早的寻找到最优解，提高剪枝效率。</li>
</ul>
</li>
</ol>
<h2>编程题</h2>
<h3>变治法</h3>
<ol>
<li>
<p>变治法解数列多数元素问题：</p>
<ul>
<li>
<p>思路：先排序，然后线性扫描。复杂度O(nlogn) + O(n) = O(nlogn)</p>
</li>
<li>
<p>算法：</p>
<pre><code>sort(src);//对整数序列进行排序
count = 0;
num = src[0];
temp = floor(n / 2)
for( i = 0; i &lt; n; i++)
{
    if(num == src[i])
    {
        count ++;
        if(count &gt; temp)
        {
            cout &lt;&lt; "Exist" &lt;&lt; endl;
            break;
        }
    }
    else
    {
        num = src[i];
        count = 1;
    }
}
if(i == n)
    cout &lt;&lt; "Doesn't exist" &lt;&lt; endl;
</code></pre>
</li>
</ul>
</li>
</ol>
<h3>分治法</h3>
<ol>
<li>
<p>变治法解数列多数元素问题：</p>
<blockquote>
<p>https://leetcode-cn.com/problems/majority-element/solution/duo-shu-yuan-su-by-leetcode-solution/</p>
</blockquote>
<ul>
<li>
<p>思路：</p>
<p>如果数 a 是数组 nums 的众数，如果我们将 nums 分成两部分，那么 a 必定是至少一部分的众数。</p>
<p>我们可以使用反证法来证明这个结论。假设 a 既不是左半部分的众数，也不是右半部分的众数，那么 a 出现的次数少于 l / 2 + r / 2 次，其中 l 和 r 分别是左半部分和右半部分的长度。由于 l / 2 + r / 2 &lt;= (l + r) / 2，说明 a 也不是数组 nums 的众数，因此出现了矛盾。所以这个结论是正确的。</p>
<p>这样以来，我们就可以使用分治法解决这个问题：将数组分成左右两部分，分别求出左半部分的众数 a1 以及右半部分的众数 a2，随后在 a1 和 a2 中选出正确的众数。</p>
</li>
<li>
<p>算法：</p>
<p>我们使用经典的分治算法递归求解，直到所有的子问题都是长度为 1 的数组。长度为 1 的子数组中唯一的数显然是众数，直接返回即可。如果回溯后某区间的长度大于 1，我们必须将左右子区间的值合并。如果它们的众数相同，那么显然这一段区间的众数是它们相同的值。否则，我们需要比较两个众数在整个区间内出现的次数来决定该区间的众数。</p>
<pre><code>class Solution:
    def majorityElement(self, nums, lo=0, hi=None):
        def majority_element_rec(lo, hi):
            # 递归终止条件，数组中仅有一个元素，众数就是他本身
            if lo == hi:
                return nums[lo]

            # 二分，寻找两边的众数
            mid = (hi-lo)//2 + lo
            left = majority_element_rec(lo, mid)
            right = majority_element_rec(mid+1, hi)

            # 如果两边的众数相同，就返回其中一边
            if left == right:
                return left

            # 否则，计算比较哪边的众数比较大
            left_count = sum(1 for i in range(lo, hi+1) if nums[i] == left)
            right_count = sum(1 for i in range(lo, hi+1) if nums[i] == right)

            return left if left_count &gt; right_count else right

        return majority_element_rec(0, len(nums)-1)

</code></pre>
</li>
<li>
<p>复杂度</p>
<p>时间复杂度：$O(n\log n)$。函数 majority_element_rec() 会求解 2 个长度为 $\dfrac{n}{2} $的子问题，并做两遍长度为 n 的线性扫描。因此，分治算法的时间复杂度可以表示为：</p>
<p>$$
T(n) = 2T(\frac{n}{2}) + 2n
$$</p>
<p>根据 主定理，本题满足第二种情况，所以时间复杂度可以表示为：</p>
<p>$$
\begin{aligned} T(n) &amp;= \Theta(n^{log_{b}a}\log n) \ &amp;= \Theta(n^{log_{2}2}\log n) \ &amp;= \Theta(n \log n) \ \end{aligned}
$$</p>
<p>空间复杂度：$O(\log n)$。尽管分治算法没有直接分配额外的数组空间，但在递归的过程中使用了额外的栈空间。算法每次将数组从中间分成两部分，所以数组长度变为 1 之前需要进行 $O(\log n)$次递归，即空间复杂度为 $O(\log n)$。</p>
</li>
</ul>
</li>
<li>
<p>分治算法解逆序元素对的数目</p>
<ul>
<li>
<p>思路：</p>
<ul>
<li>划分
<ul>
<li>对一个序列划分为左右两个子序列（当划分到最后只剩下两个元素时便可直接判断），逆序对的有三种存在情况：1.在左子序列中；2.在右子序列中；3.由左右子序列共同构成。</li>
<li>当划分到只剩下一个元素时，开始回溯合并</li>
</ul>
</li>
<li><strong>求解</strong>：左右子序的元素顺序遍历比较大小（即归并排序的比较）</li>
<li><strong>合并</strong>：合并过程中左右子序均按升序排序，当出现左子序列元素值大于右子序列中的某个元素值时，此时<strong>左子序列中的该元素及其后面的所有元素</strong>，均可与右子序列中的这个元素构成<strong>逆序对</strong></li>
</ul>
</li>
<li>
<p>算法：</p>
<pre><code>class Solution:
    def mergeSort(self, nums, tmp, l, r):
        if l &gt;= r:
            return 0

        mid = (l + r) // 2
        # 划分，计算左右两个子序列的各自逆序数
        inv_count = self.mergeSort(nums, tmp, l, mid) + self.mergeSort(nums, tmp, mid + 1, r)
        # 合并
        i, j, pos = l, mid + 1, l
        while i &lt;= mid and j &lt;= r: # 两个子序列依次从前往后遍历
            if nums[i] &gt; nums[j]: # 前半段出现了比 后半段大的元素
                tmp[pos] = nums[i]
                i += 1
                inv_count += (j - (mid + 1)) # 这时，左序列中的该元素，及其后面的所有元素，均可与右序列中的这个元素构成逆序对
            else:
                tmp[pos] = nums[j] # 否则，正常排序
                j += 1
            pos += 1
        for k in range(i, mid + 1): # 右半段用完，这时，左半段剩余所有元素，都可以与右半段最后一个元素构成逆序对
            tmp[pos] = nums[k]
            inv_count += (j - (mid + 1))
            pos += 1
        for k in range(j, r + 1): # 左半端用完，正常排序
            tmp[pos] = nums[k]
            pos += 1
        nums[l:r+1] = tmp[l:r+1]
        return inv_count

    def reversePairs(self, nums: List[int]) -&gt; int:
        n = len(nums)
        tmp = [0] * n
        return self.mergeSort(nums, tmp, 0, n - 1)

</code></pre>
</li>
<li>
<p>复杂度：</p>
<p>记序列长度为 n。</p>
<p>时间复杂度：同归并排序 O(nlogn)。
空间复杂度：同归并排序 O(n)，因为归并排序需要用到一个临时数组。</p>
</li>
<li>
<p>与暴力解法比较：</p>
<p>暴力解法：使用两层 <code>for</code> 循环枚举所有的数对，逐一判断是否构成逆序关系。时间复杂度：$O(n^2)$; 空间复杂度：O(1)。</p>
</li>
</ul>
</li>
<li>
<p>设计一求解以下问题的分治算法，写出伪代码，分析其时间复杂性并与该问题的蛮力算法相比较</p>
<p>问题描述：设有 n=2 k 个运动员要进行网球循环赛。现要设计一个满足以下要求 的比赛日程表：</p>
<p>​	（1）每个选手必须与其他 n-1 个选手各赛一次；</p>
<p>​	（2）每个选手一天只能参赛一次；</p>
<p>​	（3）循环赛在 n-1 天内结束。</p>
<p>请按此要求将比赛日程表设计成有 n 行和 n-1 列的一个表。在表中的第 i 行，第 j 列处填入第 i 个选手在第 j 天所遇到的选手。其中 1≤i≤n，1≤j≤n-1。</p>
</li>
<li>
<p>设计一求解以下问题的分治算法，写出伪代码，分析其时间复杂性并与该问题的蛮力算法相比较：</p>
<p>某投资咨询公司要长期重复做一项模拟，在这项模拟中他们从过去的某天开始对一支给定的股票连续考察n天（这些天数记为 i = 1,2,...n）；对每天i，有当天这只股票每股的价格p(i)（为简单起见，我们假设这个价格在每一天之内是固定的）。 假设在这n天内，某天买进这支股票并且在以后的某天卖出这些股票，欲求：为了挣到最多的钱，他们应该什么时候买进并且什么时候卖出？</p>
<p>举例说，假设n=4，p(1)=4，p(2)=1，p(3)=1.5，p(4)=3，那么你的算法应该返回“2买，4卖”（在第2天买并且在第4天卖意味着每股将挣2美元，是这个期间最大的收益）。</p>
</li>
</ol>
<h3>减治法</h3>
<p>写出一具有减治思想的求$log_2N$的算法，并推导其时间复杂性。</p>
<h3>动态规划</h3>
<ol>
<li>某工厂调查了解市场情况，估计在今后四个月内，市场对其产品的需求量如下表所示。（仓储问题？）</li>
</ol>
<table>
<thead>
<tr>
<th>时期（月）</th>
<th>需要量（产品单位）</th>
</tr>
</thead>
<tbody>
<tr>
<td>1</td>
<td>2</td>
</tr>
<tr>
<td>2</td>
<td>3</td>
</tr>
<tr>
<td>3</td>
<td>2</td>
</tr>
<tr>
<td>4</td>
<td>4</td>
</tr>
</tbody>
</table>
<p>已知：对每个月来讲，生产一批产品的固定成本费为3 (千元)，若不生产，则为零。每生产单位产品的成本费为1 （千元)。同时，在任何一个月内，生产能力所允许的最大生产批量为不超过6个单位。</p>
<p>又知每单位产品的库存费用为每月0.5 （千元），同时要求在第一个月开始之初， 及在第四个月末，均无产品库存。</p>
<p>问：在满足上述条件下，该厂应如何安排各个时期的生产与库存，使所花的总成本费用最低？写出你所设的状态变量、决策变量、状态转移方程与递推关系式，和手工求解的详细步骤及结果。</p>
<ul>
<li>
<p>状态变量：$x_k$ ：第 k 月初的存储量</p>
</li>
<li>
<p>决策变量：$u_k$ ：第 k 月的产量</p>
</li>
<li>
<p>状态转移方程：$x_{k+1} = x_k + u_k - s_k$</p>
</li>
<li>
<p>指标函数：$V_{k,n} = \sum_{j=k}^n v_j(x_j,u_j)$</p>
<p>$v_k=0.5x_k+u_k + 3I_{u_k\neq1}(u_k)$</p>
<p>允许决策集合：$D_k(x_k) = {u_k| 0\le u_k \le 6, u_k + x_k - s_k &gt; 0}$</p>
</li>
<li>
<p>递推关系式：</p>
<p>$$
\left{\begin{array}{l}
f_{5}\left(x_{5}\right)=0 \
f_{k}\left(x_{k}\right)=\min <em>{u</em>{k} \in D_{k}\left(x_{k}\right)}\left{0.5 x_{k}+u_k+3I_{u_k\ne1}(u_k)+f_{k+1}\left(x_{k+1}\right)}\right.
\end{array}\right.
$$</p>
</li>
</ul>
<ol>
<li><img src="https://www.pppp.ink/images/2021-06-20-1624188279-2021-01-08image-20210108110900701j74ZOr.png" alt="image-20210108110900701" /></li>
</ol>
<ul>
<li>
<p>状态变量：剩余的投资金额：$x_k$</p>
</li>
<li>
<p>决策变量：为每个项目投资的数额：$u_k$</p>
</li>
<li>
<p>状态转移方程：$x_{k+1} = x_k-u_k$</p>
</li>
<li>
<p>指标函数：$V_{k,n} = \sum_{j=k}^n v_j(x_j,u_j)$</p>
<p>$v_k=s[x_k] - x_k$</p>
<p>允许决策集合：$D_k(x_k) = {u_k|0\le u_k \le x_k}$</p>
</li>
<li>
<p>递推关系式：</p>
<p>$$
\left{\begin{array}{l}
f_4(x_4) = 0 \
f_k(x_k) = \max_{u_k\in D_k(x_k)}{ s[x_k] - x_k + f_{k+1} (x_{k+1}) }
\end{array}\right.
$$</p>
</li>
</ul>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188285-2021-01-09image-202101091106093181IwJ9i.png" alt="image-20210109110609318" /></p>
<ol>
<li>
<p>写出用动态规划方法求两个序列的最长公共子序列算法的递推 公式、伪代码和时间复杂性，并用该算法手工计算以下 X 和 Y 的最长公共子 序列：</p>
<p>X=abcbcc，Y=cacbac</p>
</li>
<li>
<p>设计一基于动态规划思想求解以下问题的算法，写出递推关系式、伪代码，并分析你所设计的算法的时间复杂性：</p>
<p>一条公路由西到东长M公里，公路两旁可能设立广告牌的地点为 x ，而在各地点放置一块广告牌带来的收益分别 p。有关规定要求两块广告牌的距离不能小于3公里。要求找到一组地点来放置广告牌，使得总收益最大。</p>
</li>
</ol>
<h3>分支定界</h3>
<p>某部门欲建立联通分布于五个区的共50个站点的有线通信网络。每两个站点之间的线路敷设费用由对称矩阵C给出。任意两站点之间敷设线路需建设的地井数目由对称矩阵U给出。</p>
<p>设计一线路敷设总费用为最小的无环网络，使得需建设的总地井数目不超过UMAX，且需跨区敷设的线路总数目不超过DMAX（各站点所属的区由向量D给出）。</p>
<ol>
<li>说明你是如何构造搜索树的。（要求是二叉搜索树）。</li>
<li>说明算法遍历搜索树的原则（何时以及如何前进、分支、回溯、剪枝等等）。</li>
<li>你设计的分支定界算法的“界”是什么，它为什么是正确的和有效的？</li>
<li>写出伪代码。</li>
</ol>
<ul>
<li>
<p>50 个节点的原始网络为一个无向完全图，总的边数为 50*49/2 = 1225 条，因此，以边为节点构造一个 1225 层的二叉搜索树，对所有边按照铺设费用从小到大排序，编号为 1... 1225 。对于第 i 层的分支，对应于是否把第 i 条边添加到解集中，左分支代表选择该边，右分支表示不选择该边</p>
</li>
<li>
<p>遍历搜索树的原则</p>
<ul>
<li>前进：在当前层，选择最可能达到最优的结点进行扩展，要满足欲加入的边满足网络无环、以及地井和线路数的限制</li>
<li>分支：左支表示将该边加入到解集，右支代表不将该边加入到解集</li>
<li>回溯：当前挑选的边使解不可行，或已经找到一个解时回溯，当从左分支回溯会节点时，接着遍历右分支，从右分支回溯时，回到父节点</li>
<li>剪枝：在搜索树的每个节点，进行可行性检查，并且计算下界，若当前节点不可行，或计算出的下界超过了当前已求出的最优解，则进行 剪枝</li>
<li>停止：当二叉树所有节点都被访问过时，可以找到一个最优解</li>
</ul>
</li>
<li>
<p>分支定界法的界：</p>
<ul>
<li>下界：不考虑限制条件，在当前已经敷设的线路的基础上，用修改的 Kruskal 算法，构造的最小生成树的总花费</li>
<li>正确和有效的原因：加上任何约束条件的情况下，可行解的花费均大于等于最小生成树的费用代价</li>
</ul>
</li>
<li>
<p>伪代码：</p>
<pre><code>def search(S, l):
	if（ isNoCircle(S)
			 &amp;&amp; countU(S) &lt;= UMAX
			 &amp;&amp; countD(S) &lt;= DMAX
			 &amp;&amp; minBound(S) &lt; bestSolutionNow) {
			 	if (S 已经覆盖所有站点)
			 		记录最优结果 BestS=S
			 		更新 bestSolutionNow
			 	else {
			 		search(S+l, l-&gt;left)
			 		search(S, l-&gt;right)
			 	}
			 }
	

BuildNetwork() {
	Tree = buildTree() # 初始化，根据边集合，构造二叉搜索树
	search(空集，Tree-&gt;root)
	return BestS
}
</code></pre>
</li>
</ul>
<p>A国和B国之间尚未直接通商。但是，与A国直接通商的有20个国家(C1、C2、…C20)；与B国直接通商的为另外30个国家（C21、C22、…C50）。上述50个国家(C1、C2…C50)之间并不是每两个国家都直接通商，任意两国之间的贸易税率由对称矩阵R给出，其中“无穷大”代表两国之间不能直接通商。</p>
<p>​    A国某公司和B国某公司欲通过某几个中间国家的公司完成一笔贸易，各个国家的进出口贸易通关等程序所需办理时间由向量T给出。请安排一个中转贸易计划，使得该交易所产生的向各中转国缴纳的税费最低，且整个交易能够在时间t内完成。</p>
<p>1、 说明你是如何构造搜索树的（要求是二叉搜索树）</p>
<p>2、 说明算法遍历搜索树的原则（何时以及如何前进、分支、回溯、剪枝等等）</p>
<p>3、 你设计的分支定界算法的“界”是什么，他为什么是正确的和有效的？</p>
<p>4、 写出伪代码。</p>
<ul>
<li>
<p>如何构造搜索树：根节点为 A 节点，每个节点的左分支表示其代表的国家为下一个贸易顺序上的国家，右分支表示该国家不加入贸易顺序。树的每一个节点由之前的贸易顺序 S，和已经否决的国家 V 构成，初始化 S = &lt;A&gt;, V = 空集∅ 任取可以和s国贸易的国家c（不属于S和V）置于树的当前生成位置，然后用（S' = &lt;S, c&gt;和V' = V ∪ ∅）生成左子树，用（S' = S和V' = V ∪ {c}）生成右子树。如果c不存在或者s = B则终止当前子树的生成。</p>
</li>
<li>
<p>每个节点保存当前的贸易顺序 S、和已经否决的国家列表 V，初始化根节点为 S=&lt;A&gt;, V = 空集，寻找可以和当前贸易顺序尾部国家直接通商，且不属于 S 和 V 的国家 c，左子树表示贸易顺序上的下一个国家为 c， 用（S' = &lt;S, c&gt;和V' = V ）生成左子树。右子树表示不与 c 进行贸易，用（S' = S和V' = V ∪ {c}）生成右子树。如果c不存在或者s = B则终止当前子树的生成。</p>
</li>
<li>
<p>遍历搜索树的原则：</p>
<ul>
<li>前进：当前节点未被剪枝，并且仍有子节点</li>
<li>分支：先遍历左分支，再遍历右分支</li>
<li>回溯：找到一个可行解，或当前节点被剪枝，则返回父节点</li>
<li>剪枝：
<ul>
<li>当前节点贸易税费下界 &gt;= 已求得最优解</li>
<li>当前节点贸易所需时间下界 &gt; t</li>
</ul>
</li>
</ul>
</li>
<li>
<p>下界：</p>
<ul>
<li>税费下界和时间下界，可由最短路径算法，构造当前节点到 B 的最短时间 和最短税费路径 + 当前已经确定的税费和时间 得到</li>
<li>正确和有效的原因：下界弱化了限制，在加上任何约束条件的情况下，可行解的花费均大于等于最短路径的费用代价</li>
</ul>
</li>
<li>
<p>伪代码：</p>
<pre><code>def Trade(C, R, T, t):
	# C:国家列表， R 贸易税率矩阵，T:贸易时间矩阵，t:交易最大时间
	Search(&lt;A&gt;,  ∅)
	return 最优解
	
def Search(S, V):
	s = S.last
	if (minTaxBound(S, R) &lt; bestTax &amp;&amp; minTimeBound(S, T) &lt;= t)
		if s == b:
			记录 S 为当前最优解；更新 bestTax
		else:
			寻找可以和 s 进行贸易，且不属于 S，不属于 V 的国家 c：
				Search(&lt;S,c&gt;, V)
				Search(&lt;S&gt;, &lt;V,c&gt;)
		
</code></pre>
</li>
</ul>
<h3>近似算法</h3>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188298-2021-01-09image-2021010915330364335dy9W.png" alt="image-20210109153303643" /></p>
<ul>
<li>
<p>对每个顶点 $v_i\in V$ 定义变量 $x_i$ 使得，当 $v_i \in C$ 时，$x_i = 1$ 否则，$x_i=0$ 。约束条件：对任意边$(v_i, v_j)$ ，两个顶点至少有一个必须在顶点覆盖 C 中，即$x_i+x_j \ge 1$</p>
</li>
<li>
<p>贪心算法，每一轮更新集合的权重为 wi/(Si - C) ，即集合的权重/加入这个集合后，新增的元素个数，每轮将最小权重的集合加入到 C 中，直到 C 为全集 U</p>
<blockquote>
<p>Chvatal V. A greedy heuristic for the set-covering problem[J]. Mathematics of operations research, 1979, 4(3): 233-235.</p>
</blockquote>
</li>
</ul>
<h3>贪心算法</h3>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188304-2021-01-08image-20210108172605505X2NaeN.png" alt="image-20210108172605505" /></p>
<p>设计一针对以下问题的贪心算法，简述算法的基本思想，写出伪代码，并分析其时间复杂性（不一定要找到最优解）：</p>
<p>有n项任务要完成，恰好有n个人可以分别去完成其中一项，但由于任务性质和个人专长不同，因此个人去完成不同的任务的效率（或所费时间）就有差别. 设给定效率矩阵C，矩阵的元素 表示第i人去完成第j项任务所需的时间，则如何分派这n个人去完成这n项任务能使花费的总时间最少。</p>
<h2>其他</h2>
<p>设计一种策略，使在下面的游戏中，期望提问的平均次数最少（请给出你得到这一策略的过程）：一副纸牌，由一张A，两张2，三张3，直到9张9组成。有人从洗过的这副牌中抽出一张，你需要问一连串用是或否来回答的问题来确定这张牌的点数。</p>
<p>设计一种策略，使在下面的游戏中，期望提问的平均次数最少（请给出你得到这一策略的过程）：</p>
<p>一个黑盒内共有1个红球，2个蓝球，3个绿球，4个黄球，5个黑球，6个白球，7个紫球。有一个人从黑盒内随机拿出一个球，另一个人被蒙上眼睛，只能通过一连串用是或否来回答的问题来确定球的颜色，问该蒙眼人的提问策略。</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-20T11:19:32.001Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[北航 研究生 分布式操作系统考试内容]]></title>
        <id>https://www.pppp.ink/docs/buaa/2-fen-bu-shi-cao-zuo-xi-tong.html</id>
        <link href="https://www.pppp.ink/docs/buaa/2-fen-bu-shi-cao-zuo-xi-tong.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[大概是人生中最后一场专业课考试，接下来又会有怎样的考验？我们的征途是星辰大海 笔者参与了 2021 年的北航计算机学院研究生分布式操作系统考...]]></summary>
        <content type="html"><![CDATA[<p>大概是人生中最后一场专业课考试，接下来又会有怎样的考验？</p>
<blockquote>
<p>我们的征途是星辰大海</p>
</blockquote>
<h2>考试考了啥？</h2>
<p>笔者参与了 2021 年的北航计算机学院研究生分布式操作系统考试，考试是开卷考试，大概考了下面的内容：</p>
<ul>
<li>论述题：
<ul>
<li>alice 和 bob 想要实现交易，他们在安全性上需要注意什么</li>
<li>一致性和复制的意义，给了两个一致性模型的图，判断达到了怎样的一致性模型，为什么</li>
</ul>
</li>
<li>简答题 和 概念题：
<ul>
<li>什么是分布式系统，什么是分布式操作系统</li>
<li>什么是逻辑时钟，什么是 lamport 逻辑时钟</li>
<li>分布式系统的挑战是什么，研究方法是什么</li>
<li>RPC 中存在哪些问题， 以 read 远程方法为例，简述 RPC 的实现原理</li>
<li>进程迁移的研究策略和方法</li>
<li>什么是面向消息的瞬时通信，什么是面向消息的持久通信</li>
<li>什么是递归名称解析，什么是迭代名称解析</li>
<li>拜占庭问题是怎么解决的，三副本容错能否解决拜占庭错误</li>
</ul>
</li>
</ul>
<h3>感受</h3>
<p>说真的，开卷考试的话，大部分内容在书上都能找到，而且老师最后一节课还划了重点。但是，题目真的多，要写的内容好多，一共有六页卷子，差点写不完。而且总感觉好多内容答得并不到位...</p>
<h2>1. 概论</h2>
<ul>
<li>
<p>分布式系统的定义：</p>
<ul>
<li>分布式系统是若干 ==独立== 计算机的集合，这些计算机对于用户来说就像是一个 ==单一== 的系统</li>
<li>Andrew S. Tanenbaum：<strong>一组独立的计算机系统，但是对 用户 看起来像是一个 单一 的计算机</strong></li>
<li>分布式系统通常表现出中间件的形式</li>
</ul>
</li>
<li>
<p>分布式系统基本特性</p>
<ul>
<li>系统由并行执行部件组成</li>
<li>==系统没有共享内存==</li>
<li>==系统中无全局时钟==</li>
<li>==没有节点拥有全局信息状态==</li>
<li>系统部件可能失效</li>
<li>系统具有容错机制</li>
<li>多副本需具有一致性，保证扩展性</li>
</ul>
</li>
<li>
<p><strong>单机操作系统与分布式操作系统的区别</strong></p>
<ul>
<li>围绕基本特性，阐述自己的观点</li>
<li>缺乏自治性，强调统一操作系统下整体控制</li>
</ul>
</li>
<li>
<p><strong>网络操作系统与分布式操作系统的区别</strong></p>
<ul>
<li>主要目标是资源共享，缺乏透明性。</li>
<li>网络操作系统：
<ul>
<li>主要目标是信息共享和提供非透明服务，用户具有完全的自治 性。对全局管理、并行操作、自治控制等特性无硬性要求，结 点之间物理联系、逻辑关系松散，强调个性，没有一个完全一 致的系统状态图。</li>
</ul>
</li>
<li>分布式操作系统：
<ul>
<li>所有的系统资源都是对用户开放的，用户就像在使用一个完整 的单机 (基于微内核的和现有OS之上的二种构建方法）</li>
<li>每个机器安装统一的微内核以连接各不同的硬件系统，微核结 构减小了操作系统尺寸，隐藏了硬件的异构性</li>
<li>分布式系统中处理机只有很少的自治性，主要由DOS和系统管理员统一管理</li>
</ul>
</li>
<li>两者区别：
<ul>
<li>
<p>与分布式系统的最根本区别：
透明性：对用户屏蔽系统组件的分散性 [ISO 1992]:
• 访问透明性: 相同操作访问本地和远程资源
• 位置透明性：不需要知道资源位置就可访问
• 并发透明性：几个进程能并发共享资源，互不干扰
• 复制透明性：无需知道副本的存在
• 故障透明性：屏蔽错误
• 移动透明性：不影响应用的情况下，允许资源和客户移动
• 性能透明性：负载变化时，允许系统重构
• 伸缩透明性：不改变系统结构前提下，允许系统扩展</p>
</li>
<li>
<p>文件系统：</p>
<ol>
<li>没有操作系统方法：文件传送（如USENET网络）</li>
<li>网络操作系统方法：把不同文件系统连接起来 Open (“/machine1/pathname”,READ)</li>
<li>分布式操作系统方法：所有各子系统的文件系统组成一 个整体文件系统，任何机器想要读password文件时 open(“/etc/password”,READ ONLY) 不必指出该文件在哪里（LOCUS）</li>
</ol>
</li>
<li>
<p>访问控制：</p>
<p>用户标识（UID）问题：多机远程访问不唯一性</p>
<ol>
<li>没有操作系统时：使用远程机器上用户名。</li>
<li>网络操作系统时：对不同机器的UID进行变换，需要提供一个充分大的变换表</li>
<li>分布式系统中：单一的UID</li>
</ol>
</li>
<li>
<p>执行地点：</p>
<p>用户运行一个程序时，在哪里运行？</p>
<ol>
<li>没有操作系统时：远程登录，然后运行在那里的作业</li>
<li>网络操作系统时：指定一个机器运行 remote vax4 job</li>
<li>分布式操作系统: 用户只需要简单提交job,由操作系统 寻找合适的处理机，用户察觉不到机器的边界。</li>
</ol>
</li>
</ul>
</li>
</ul>
</li>
<li>
<p>分布式系统的中间件模式</p>
<ul>
<li>
<p>分布式系统DOS具有上述的优势，却并不实用，其主要原因：</p>
<p>• 技术难度大；</p>
<p>• 继承性差，一般需对底层重新开发；</p>
<p>• 现实中存在大量的独立设备，具有自治性，很难把它们联入分 布式系统、</p>
</li>
<li>
<p>中间件模式可以 增加系统透明性， 抑制网络用户自治性 屏蔽底层异构性</p>
</li>
</ul>
</li>
<li>
<p>==分布式操作系统目标，必须做到四件事== ：</p>
<ul>
<li>资源可访问：能够使用户方便地访问资源</li>
<li>透明性：必须隐藏资源在一个网络上分布</li>
<li>开放性</li>
<li>可扩展性</li>
</ul>
</li>
<li>
<p>基本研究方法</p>
<ul>
<li>合理的假设：通信问题带来的影响</li>
<li>动态方法，静态方法</li>
<li>最大最小问题</li>
<li>管理系统和数据本身是分布式的：DNS
<ul>
<li>解决分布式的问题，但本身是分布式</li>
</ul>
</li>
</ul>
</li>
<li>
<p><strong>三种可扩展性技术是什么：</strong></p>
<ol>
<li>隐藏通信等待时间：采用异步通信的方式，发出通信操作后执行其他工作，不单纯等待响应；启动新的控制线程执行请求；将部分工作分散给客户</li>
<li>分布技术：将某组件分割为多个部分，分散到系统中</li>
<li>复制技术（解决性能下降问题）：能增加可用性、有助于负载平衡、新问题：一致性问题、解决：全局同步机制</li>
</ol>
</li>
<li>
<p>分布式操作系统内容：</p>
<p>&lt;img src="/images/2021-06-20-1624188565-2021-06-14image-20210614101443860GfJYST.png" alt="image-20210614101443860" style="zoom:67%;" /&gt;</p>
</li>
</ul>
<h2>2. 体系结构</h2>
<h3>2.1 ==四种软件体系结构== ：P24</h3>
<ol>
<li>分层体系结构</li>
<li>基于对象的体系结构</li>
<li>以数据为中心的体系结构</li>
<li>基于事件的体系结构</li>
</ol>
<h3>2.2 基本概念</h3>
<ul>
<li>
<p>平均响应时间（Mean Response Time）：响应时间是任</p>
<p>务从提交到结束的时间，系统的平均响应时间指系统中 所有任务的平均响应时间，反映的是系统的整体性能。 设任务的到达率为 $\lambda$，系统的服务率为 $\mu$，则系统平均 响应时间为T＝1/($\mu-\lambda$)</p>
</li>
<li>
<p>系统可用性：系统可用性定义为：平均无故障时间MTTF / (MTTF+平均维护时间MTTR)</p>
</li>
<li>
<p>加速比（Speed Up）：定义为一个程序串行执行花费的时间和并 行执行所用时间的比值，用于衡量一个并行执行的程序效能。</p>
<ul>
<li>Ts为串行执行的墙钟时间， Tp为并行执行的墙钟时间， 则 加速比 Sp＝Ts/Tp。</li>
<li>f=tp/Ts为并行化率; 即：tp=f×Ts，</li>
</ul>
</li>
<li>
<p>Amdahl定律：Sp = 1/[(1-f )+f/n]当n－&gt; 无穷  Sp－&gt;1/ (1-f )。</p>
<ul>
<li>当程序中串行成份一定时，处理机数增加到一定时，再增加处 理机数，加速比也不会无限增大。</li>
<li>程序的串行部分是瓶颈，为获取好的加速比，应使并行化率尽量大。</li>
</ul>
</li>
</ul>
<h2>3. 进程迁移 （分布式进程）</h2>
<h3>3.1 进程概念</h3>
<ul>
<li>
<p>进程是程序的一次执行</p>
</li>
<li>
<p>进程是系统中独立存在的实体，它可以拥有自己独立的 资源，比如文件和设备描述符等。在没有经过进程本身 允许的情况下，其他进程不能访问到这些资源。这一点 上和线程有很大的不同。</p>
</li>
<li>
<p>进程与程序的区别在于，程序只是一个静态的指令集合 ，而进程是一个正在系统中活动的指令集合。</p>
</li>
<li>
<p>进程运行的环境称为进程上下文，进程的上下文由进程控制块PCB(process control block)、 正文段(text segment)、数据段(data segment)以及用户堆 栈(stack)组成。</p>
</li>
</ul>
<h3>3.2 内核级线程和用户级线程</h3>
<ul>
<li>内核级线程（KLT）中的所有线程的创建、调度和管理 全部由操作系统内核负责。当一个线程想去创建一个 新线程或撤消已存在的线程时，它发出一个内核调用 ，由它完成创建和回收工作</li>
<li>轻量级进程（Lightweight processes,LWP)，线程包完全在用户空间实现，可以由多个LWP共用，阻塞调用时，转到内核模式。不会导致整个进程阻塞。线程；创建、注销及同步开销小，不需要内核干预。如有足够多LWP，则阻塞调用不会导致整个进程挂起。 LWP是隐式执行，对程序员透明可在多处理器系统上方便地应用</li>
</ul>
<h3>3.3 进程选举</h3>
<ul>
<li>
<p><strong>同步环中领导者选举</strong></p>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188571-2021-06-14image-20210614105648974JIHxJf.png" alt="image-20210614105648974" /></p>
<ul>
<li>
<p>停止和非领导者输出 LCR算法无法停止 增加：选出的领导者发通知消息，收到通知进程传递消息后停止 变形：在消息上附上领导者进程下标，可以参与进程都输出领导者</p>
<p>复杂度：</p>
<p>时间复杂度是n轮 通信复杂度是O(n^2)</p>
</li>
</ul>
</li>
<li>
<p>算法证明：</p>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188580-2021-06-14image-20210614105759360UqkiJk.png" alt="image-20210614105759360" /></p>
<p>分布式中一般要有一个leader，层次结构，但leader具有分布式特征，动态选举，和固定leader不是一个概念</p>
</li>
<li>
<p><strong>BUlly 欺负 算法</strong></p>
<ul>
<li>
<p>将进程进行排序</p>
<ul>
<li>
<p>① P向高的进程发E 消息</p>
<p>② 如果没有响应， P选举获胜</p>
<p>③ 如果有进程Q响应,则P结束，Q 接管选举并继续 下去。</p>
</li>
</ul>
</li>
</ul>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188585-2021-06-14image-20210614105939473fJzMYJ.png" alt="image-20210614105939473" /></p>
</li>
</ul>
<h3>3.4 代码迁移</h3>
<ul>
<li>
<p>关键研究问题：</p>
<ul>
<li>
<p><strong>迁移进程的状态收集、传输、恢复问题；</strong></p>
<ul>
<li>
<p>收集</p>
<ul>
<li>内部状态收集：进程主动调用状态收集函数对自身进 行状态收集。这种方式将状态收集函数直接写入程序 代码，由用户主动启动进程迁移</li>
<li>外部状态收集：这种方法将需要迁移的进程挂起，然 后通过操作系统提供的特殊系统接口对该进程进行状 态收集</li>
<li>触发式状态收集：由信号触发导致进程对自身进行状 态收集。这种方式中，需要在程序中设置特殊的迁移 信号及信号处理函数，当迁移进程接收到迁移信号时 ，就会进入相应的信号处理函数进行自身状态收集</li>
</ul>
</li>
<li>
<p>传输</p>
<ul>
<li>全拷贝算法：即在完全传输所有的状态信息后，再重 启迁移进程</li>
<li>预拷贝方式：迁移发起时，先将当时的虚存空间传到 目标节点机上，而迁移进程在源节点机上继续运行。 然后挂起进程，再追加拷贝这段时间内改变过的内存 页。</li>
<li>惰性拷贝技术：先将进程的基本状态信息传输到 目标节点机，恢复进程并在目标节点机上继续运 行时，要读内存哪一页就从源节点机上传过来。</li>
</ul>
</li>
</ul>
</li>
<li>
<p><strong>进程的远程透明执行问题；</strong></p>
<ul>
<li>有可能由于主机状态 改变而导致一系列复杂的问题，其中较为常见的有： 由于文件访问位置改变而导致无法访问；某些和位置 有关的系统调用无法实现等。</li>
<li>转发技术：往往针对一些与位置有关的操作，如部分 系统调用、信号处理等。转送回源结点进行处理后再 将结果返回到目的结点的方法，但是对源结点和目的 结点的性能都会造成一定的影响，并带来对源结点的 剩余依赖性。</li>
<li>单一系统映象：使文件访问可以独立 的方法来解决，这样不管在系统的任何位置执行这类 操作，都不用关心或修改相对位置的信息，保证当进 程迁移到新位置后，不用修改访问文件的位置，可以 和迁移前一样正确的访问到文件。</li>
</ul>
</li>
<li>
<p><strong>迁移进程的通信处理问题</strong></p>
<ul>
<li>迁移进程新位置可识别，即迁移完成后，其它进程仍 然可以保持和迁移进程的正常通信
<ul>
<li>建立进程地址映射表，在用户进程发送/接收消息 时，先进行地址匹配，引导以旧地址为目的地的消息 转向新的地址位置；</li>
<li>采用特殊路由方式，让进程迁移后，通信地址不变 ，而增加路由信息映射表，该表中记录迁移进程的实 际位置</li>
</ul>
</li>
<li>不丢失任何消息，即在迁移过程的临界阶段不能导致 任何消息丢失；
<ul>
<li>
<p>发送/发自迁移进程的用户消息分成三类：</p>
<ul>
<li>类型一：在迁移过程开始前发送，且在迁移过程开 始前能到达目的进程的消息（没丢失，过程前）。
<ul>
<li>在进程迁移之前，发送特殊消息信号，通知其它进程 此进程将要迁移，并得到它们的认可保证在迁移过程 中不发送任何消息给迁移进程。</li>
<li>消息驱赶方法：将所有的中途消息驱赶到目标进程之 后，再进行进程迁移过程，并保证在迁移过程中不再 发送任何中途消息</li>
</ul>
</li>
<li><strong>类型二：在迁移过程完全结束后发送的消息（依赖 新位置识别，过程后）。</strong></li>
<li><strong>类型三：在迁移过程前或迁移过程中发出，且尚未 被目的进程接收到的消息，以及在迁移过程中发送 的消息，这一类消息称为“中途消息”（过程中）</strong>
<ul>
<li>消息重定位方法：迁移过程中，其它进程仍然发送消 息给源结点，源结点缓存所有收到的发给迁移进程的 消息，待迁移结束后，再转发这些消息到目的结点。</li>
<li>消息丢失恢复方法：在迁移过程中发送的消息都将丢 失，待迁移完毕后，重新建立连接并重新发送消息</li>
<li>消息丢失保护方法：由源结点通知迁移进程的新地址 ，消息先发送到新结点暂存，待迁移进程恢复执行时 ，从本地缓存中取得消息。</li>
</ul>
</li>
</ul>
</li>
</ul>
</li>
<li>保证接收消息的正确接收顺序
<ul>
<li>消息分片标识：对于过长的消息，系统可能把它分解成多个消 息碎片传送，接收消息时，应该保证消息碎片的正确顺 序</li>
<li>排队顺序</li>
</ul>
</li>
</ul>
</li>
</ul>
</li>
<li>
<p>总结：研究问题：</p>
<ul>
<li>
<p>进程迁移的步骤和实现层次</p>
</li>
<li>
<p>迁移进程的状态收集、传输、恢复问题（进程状态收 集，传输方法）</p>
</li>
<li>
<p>进程的远程透明执行问题（转发机制和修改）；</p>
</li>
<li>
<p>迁移进程间的通信处理问题</p>
<p>–迁移进程新位置可识别（地址映射和特殊路由）</p>
<p>–不丢失任何消息（消息驱赶法和消息转发方法）</p>
<p>–保证接收消息的正确接收顺序（消息分片标识和排队顺序）</p>
</li>
<li>
<p>进程迁移算法： 异步，同步和类异步算法</p>
</li>
</ul>
</li>
</ul>
<h3>3.5 进程迁移步骤：</h3>
<p>[Step 1] 询问目标处理机是否可以接受迁移进程 ；</p>
<p>[Step 2] 得到目标处理机的肯定答复后，在目标处理机上创建恢复进程 ；</p>
<p>[Step 3] 中断迁移进程的运行程序；</p>
<p>[Step 4] 在源处理机上收集迁移进程状态 ；</p>
<p>[Step 5] 将迁移进程状态传输到目标处理机</p>
<h2>4. 负载平衡</h2>
<h3>4.1 研究负载平衡的基本问题：</h3>
<p>何时开始转移任务以平衡系统负载，即时机或触发点问题。</p>
<p>怎样比较不同处理机的工作负载，确定某个处理机应转移负载。</p>
<p>在选定要转移任务的处理机中，选择那些任务进行迁移。</p>
<p>那一个处理机是这些任务转移的最合适的目的处理机。</p>
<p>系统中那个或那些处理机负责完成搜寻目的处理机的工作。</p>
<p>在负载再分配时需考虑什么参数 必要的帮助决策的处理机信息是集中存储管理还是分布存储管理</p>
<p>是单处理机做决策还是多个处理机协同做出决策采取什么样的机制。</p>
<p>在完成负载平衡时，怎样找到性能和 效率的平衡点。</p>
<p>怎样避免使轻负载机变成重负载机， 从而引发循环任务转移</p>
<h3>4.2 进程迁移的三大研究策略</h3>
<ol>
<li>
<p>WHEN 传输策略</p>
<p>传输策略决定负载平衡的时机，一个基本 问题是如何衡量负载的大小，</p>
<ul>
<li>
<p>衡量负载大小指标要求</p>
<ul>
<li>测量开销低，较易获得和计算，以满足频繁 测量的需要。</li>
<li>能客观体现所有竞争资源上的负载。</li>
<li>各个负载指标在测量及控制上彼此独立</li>
</ul>
</li>
<li>
<p>负载指标</p>
<ul>
<li>
<p>Platform LSF使用资源队列长度作为负载指标。认为CPU队列长 度和I/O队列长度分别与CPU类作业和I/O类作业有密切关系。</p>
<p>• Ferrari 提出使用各种资源队列长度的线性组合作为负载指标。 但其条件是假定系统处于稳定状态，并且要求资源是排队顺序的 （如FCFS）。</p>
<p>• Bonomi等人使用处理机上活动的进程数的瞬时信息和周期搜集到 的平均CPU运行队列等信息的组合作为负载指标。但不能反映资源 利用率。</p>
<p>• Kunz等人研究了运行队列任务数、系统调用率、进程切换率、空 闲主存大小、1分钟平均负载和空闲CPU时间 6项负载指标及其组 合。进行性能对比，但其实验规模较小（4个结点）</p>
</li>
</ul>
</li>
</ul>
</li>
<li>
<p>WHERE 定位策略 选择目的处理机</p>
<ul>
<li>自定位：仅使用目的处理机的名字等属性进行定位</li>
<li>本地定位：每个处理机存储定位信息，但这些信息不能保证和当前系统的一致，从而有可能导致失败。</li>
<li>服务器定位：一个特殊的服务器用于完成任务到目的 处理机的映射</li>
<li>广播方式：广播定位消息，接收合适的应答，选择处理机</li>
<li>信息收集：
<ul>
<li>集中式：集中式是把所有处理机信息收集到 机中，由此服务器负责定位和任务调度。</li>
<li>分布式：信息存储在多个物理上分布的处理机中，定 位和调度决策由这些处理机分区域作出或协商作出。</li>
<li>全局式：每个处理机定时广播负载信息到所有处理机 ，每个处理机各自作出定位和调度决策。</li>
<li>集中分布式：由一个服务负责收集信息，然后广播到 所有处理机中，每个处理机各自作出定位和调度决策</li>
</ul>
</li>
<li>选择策略：
<ul>
<li>随机策略：一种盲目方式，不需任何信息，随机定位 一个目的机。包括随机发送和随机服务。</li>
<li>门槛策略：收集部分处理机信息，随机定位一个其负 载值低于给定门槛值的处理机做目的机，重复这个过 程，直到找到目的机。</li>
<li>最短策略：收集较多的信息，随机选择一些处理机， 选择最短队列长度的处理机，如其负载低于门槛值， 则定位它为目的机，否则不迁移。</li>
<li>聚焦策略：收集更多的信息，随机选择一批处理机， 选择其剩余资源能满足任务需要的处理机。</li>
</ul>
</li>
<li>选择处理机算法
<ul>
<li>招标算法：用于在不知其它处理机信息或已有信息不能很好 找到合适处理机情况下定位目的处理机，各处理机上运行一个本地代理和一个远程代理，有任 务迁移需求的处理机的本地代理广播任务消息，同时 也接收其它处理机的任务消息。中标者还可以将任务分解再招标，它又成了招标者</li>
<li>剃度算法：各站点周期性更新信息和邻近度信息，每个站点由低水线和高水线两个参数，当负载高于高水线是过载，低于低水线时为轻载，站点邻近度反映该点到一个轻负载点的最值，轻载点邻近度为0，其他点邻近度为到所有邻近 结点中邻近度最小值。当一个结点邻近度的新值不同于旧值时，将向所有邻 近站点广播信息，当一个站点超载，向最小邻近度的站点转移一个任务。如果一个站点邻近度大于网络直径时，系统处于饱和</li>
<li>渗透算法：通过相邻域重叠部分扩散负载达到平衡：</li>
</ul>
</li>
</ul>
</li>
<li>
<p>WHICH 选择哪一个任务 决定一个任务是否适合远程执行，是否迁 移该任务，决策依赖于任务的参数、处理机负载和其它信息。</p>
<ul>
<li>选择任务一般原则
<ul>
<li>执行时间长的任务</li>
<li>计算型任务：避免交互式和IO型任务</li>
<li>独立型强任务</li>
</ul>
</li>
<li>先验知识：一般可根据先验知识形成可迁移进程表，当新产生一个进程而 有需求迁移时，查表决定该任务是否可远程执行。</li>
<li>剥夺式情况，先验知识很难保有，且任务的执行情况也无法预 知，所以一般假定无先验知识可用。所谓可迁移进程是其迁移 后能使系统的平均响应时间减少的进程。</li>
<li>预测进程生存周期：
<ul>
<li>Eager等人研究认为它服从指数分布，进程剩余运行 时间与过去状态无关，在这种情况下，所有进程被假 定具有相同的剩余运行时间，因此，策略采取选择具 有较小迁移开销的进程。</li>
<li>另有假定认为进程生存周期服从对数空间的均匀分布匀分布，剩余执行时间随已运行时间增加到某点时开 始下降。这时，应选择运行时间较长而又不太长的进 程迁移</li>
</ul>
</li>
</ul>
</li>
<li>
<p>最后的目标：收益要大于开销</p>
</li>
</ol>
<h3>4.3 迁移方式</h3>
<ul>
<li>远程执行: 是在任务调度运行时派生到远程处理机上执行的情况 一般可根据先验知识形成可迁移进程表，当新产生一个进程而有 需求迁移时，查表决定该任务是否可远程执行</li>
<li>进程迁移: 中止当前某一进程的运行迁往另一处理机上继续运行 选择可迁移进程的标准和策略是实现动态抢先式负载分担的关 键问题。所谓可迁移进程是其迁移后能使系统的平均响应时间减 少的进程。确定一个简单实用的选择可迁移进程的预测标准是十 分重要的</li>
<li>目标：收益要大于远程执行或迁移造成的开销</li>
</ul>
<h3>4.4 思考题：</h3>
<ul>
<li>3W策略的主要内容</li>
<li>该领域的主要研究点</li>
<li>设计一个信息收集机制</li>
<li>设计实现一个负载平衡算法</li>
</ul>
<h2>考试内容</h2>
<ol>
<li>名词解释：最简单的方法解释出来</li>
<li>简述题：稍微要展开，基本原理是什么</li>
<li>算法策略题（论述题）</li>
</ol>
<h2>5. 分布式系统通信</h2>
<h3>5.1 通信类型：</h3>
<ul>
<li>四种通信类型
<ul>
<li>持久通信：提交消息一直由通信中间件存储，直到该消息被传送给接收方。</li>
<li>瞬时通信：通信系统只有在发送和接收程序运行时才存储消息</li>
<li>异步通信：发送方提交传输消息后继续执行，中间件临时存储消息</li>
<li>同步通信：发送方可能被阻塞直到知道其请求被接受，被完全处理</li>
<li>不连续通信：各方以消息进行通信，每个消息是一个完整信息单元</li>
<li>流通信：一个接一个发送多个消息，消息按照发送顺序相互关联</li>
</ul>
</li>
<li>持久通信与同步通信组合：消息队列系统；瞬时通信与同步通信组合：RPC</li>
</ul>
<h3>5.2 远程过程调用 RPC</h3>
<ul>
<li>
<p>RPC 原理：程序调用其他机器上进程</p>
<p>机器 A 调用机器 B 上进程时， A 调用进程挂起，而 B 上被调用进程 开始执行，调用方将参数传到被调用进程，得到回传结果。</p>
</li>
<li>
<p>RPC 步骤</p>
<ol>
<li>client应用程序正常调用client stub</li>
<li>client stub构造消息，通过trap进入核心</li>
<li>核心将消息发送到server的核心</li>
<li>server核心将消息交给server stub</li>
<li>server stub将消息解包，用相应参数调用服务例程</li>
<li>服务例程进行计算，将结果返回server stub</li>
<li>server stub 构造消息，通过trap进入核心</li>
<li>核心将消息发送到client的核心</li>
<li>client核心接收消息并将它交给相应stub</li>
<li>stub解包，将调用结果返回应用程序</li>
</ol>
</li>
<li>
<p>参数传递</p>
<ul>
<li>数据格式问题：
<ul>
<li>统一规范格式，简单但不灵活，效率也不高</li>
<li>增加一个参数，或在消息中指明格式，由接收者做相应处理，效率较 高，但每个机器需配置完全的格式转换程序</li>
</ul>
</li>
<li>指针类参数问题：
<ul>
<li>全部禁用，不利于用户使用</li>
<li>复制/重新存储方法，client以实体代替指针，server生成缓冲区存 放实体，计算后将缓冲区打包发回</li>
</ul>
</li>
<li>复杂数据类型问题
<ul>
<li>在GIS中，指针指向图，此时需制订专门的通信协议，详细描述数 据规格，并配置相应程序读取</li>
</ul>
</li>
</ul>
</li>
<li>
<p>RPC 的实现</p>
<ul>
<li>同步：客户发RPC请求后阻塞</li>
<li>异步：客户发RPC请求后继续执行</li>
</ul>
</li>
</ul>
<h3>5.3 消息传递机制</h3>
<ul>
<li>
<p>消息类型</p>
<ul>
<li>
<p>==面向消息的瞬时通信== p101</p>
<ul>
<li>
<p>Berkeley套接字</p>
<ul>
<li>
<p>Socket 是一个基本的通信机制</p>
<p>• Socket是应用层与TCP/IP协议族通信的中间软件 抽象层，它是一组接口。</p>
<p>• Socket把复杂的TCP/IP协议族隐藏在Socket接 口后面，对用户来说，一组简单的接口就是全部， 让Socket去组织数据，以符合指定的协议。</p>
</li>
</ul>
</li>
<li>
<p>消息传递接口</p>
</li>
</ul>
</li>
<li>
<p>==面向消息的持久通信==</p>
<ul>
<li>消息队列模型</li>
<li>IBM WebSphere MQ</li>
</ul>
</li>
</ul>
</li>
</ul>
<h2>6. 命名系统 名字服务</h2>
<h3>6.1 三种类型名称</h3>
<ul>
<li>地址：实体访问点是一种特殊实体，其名字为地址</li>
<li>标识符（identifier）：唯一标识实体的名称，一对一
<ul>
<li>一个标识符最多引用一个实体</li>
<li>每个实体最多由一个标识符引用</li>
<li>一个标识符始终引用同一个实体</li>
</ul>
</li>
<li>友好名称：通常字符串表示,好记</li>
</ul>
<h3>6.2 结构化命名</h3>
<h3>6.2 递归名称解析</h3>
<ul>
<li>递归查询：对于客户端的请求或发起查询的DNS 服务器转发来的请求，若本DNS服务器无法解析(本 机数据库查询无)，自行向其它DNS服务器转发，并 将获得的查询结果返回发起者。</li>
<li>迭代查询：对于客户端或发起查询DNS服务器转 发来的请求，若本DNS服务器查询无，则告诉（返 回信息）发起者另一台DNS服务器的IP地址。</li>
</ul>
<h3>6.3 基于属性的命名</h3>
<ul>
<li>LDAP协议：轻量目录访问协议，基于IP访问X.500数据的方法</li>
<li>基于属性和DHT的方法：把属性值对映射的基于DHT的系统，使得实体标 识符集可以实现分布性。</li>
<li>语义覆盖网络：结点维护一个有关其他结点的本地列表，这些结点 语义上具有类似内容，这些语义列表可以有助于高 效搜索。</li>
</ul>
<h2>7. 同步</h2>
<h3>7.1 为什么要同步</h3>
<ul>
<li>
<p>分布式系统特点</p>
<ul>
<li>
<p>系统由分布并行执行部件构成</p>
<p>• 系统部件可能失效</p>
<p>• <strong>系统中无全局时钟</strong></p>
<p>• 通信延迟难以确定</p>
<p>• 可能超时，链路崩溃等</p>
<p>• 容错，多副本一致性问题</p>
<p>• 可能丢失，乱序，篡改，重传等</p>
</li>
<li>
<p><strong>缺乏全局的系统状态</strong></p>
</li>
</ul>
</li>
<li>
<p>分布式算法特点：</p>
<ul>
<li>§ 相关信息散布在多个场地上</li>
<li>每个进程只能基于本地信息做决定</li>
<li>应避免因单点故障造成整个系统的失败</li>
<li>不存在公共时钟或精确的全局时间</li>
<li><strong>在一处收集的信息不能推断到全局信息</strong></li>
</ul>
</li>
</ul>
<h3>7.1 逻辑时钟</h3>
<ul>
<li>
<p>什么是逻辑时钟：</p>
<ul>
<li>逻辑时钟只要保证计算机内部各时钟一致，而不是是否与真实时间接近，更近一步，能跟踪和反映计算机内部事件发生的顺序称为逻辑时钟</li>
<li>重要的不是所有进程在时间上完全一致，而是他们在事 件发生顺序上要达成一致。</li>
</ul>
</li>
<li>
<p>Lamport 逻辑时钟</p>
<ul>
<li>消息到达时, 收者时钟若比消息发送时钟小， 则立刻将其时钟调节 到比发送时间至少大一个节拍 (tick);</li>
<li>每两个事件之间时钟必须至少跳动一个节拍。 如某进程快速连发/ 连收消息，其间时钟至少跳动一个节拍;</li>
<li>若在同一个节拍内的两个进程同时发生了两事件， 则在各自发生时 间以小数形式分别附加它们自己的进程号i以示区别。</li>
</ul>
</li>
<li>
<p>Lamport 算法规则：</p>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188592-2021-06-16image-202106161851450513D51MN.png" alt="image-20210616185145051" /></p>
<p>• 每条消息须携带发送者的时钟以示离开时刻；</p>
<p>• 消息到达时, 收者时钟若比消息发送时钟小， 则立刻将其时钟调节 到比发送时间至少大一个节拍 (tick);</p>
<p>• 每两个事件之间时钟必须至少跳动一个节拍。 如某进程快速连发/ 连收消息，其间时钟至少跳动一个节拍;</p>
<p>• 若在同一个节拍内的两个进程同时发生了两事件， 则在各自发生时 间以小数形式分别附加它们自己的进程号i以示区别。</p>
</li>
</ul>
<h3>7.2 选举算法</h3>
<ul>
<li>选举算法的作用：许多分布式算法需要一个进程充当协调者， 发起者，排序者或其他特定的角色。通过选举算法，可以确定出一个协调者，方便做出统一的决定</li>
<li>欺负算法：
<ul>
<li>P向高的进程发E 消息</li>
<li>如果没有响应， P选举获胜</li>
<li>如果有进程Q响应,则P结束，Q接 管选举并继续下去。</li>
</ul>
</li>
</ul>
<h2>8. 一致性和复制</h2>
<h3>8.1 为什么需要复制</h3>
<ul>
<li>提高性能 ：通过对服务器进行复制，让他们分担工作负荷就可以提高性能</li>
<li>提高系统可靠性 ：维护多个副本，当一个副本被破坏后，文件系统只需转换到另一个数据副本就可以继续运行下去。同时多个副本可以更好的保证数据的正确性</li>
<li>提高系统效率：在使用数据的进程附近防止一份数据的副本，那么访问数据所花费的时间将会减少</li>
<li>增强系统可扩展性</li>
</ul>
<h3>8.2 一致性模型</h3>
<ul>
<li>严格一致性：对数据项的读操作返回的值应是 该数据项最近写入的相应值。</li>
<li>==顺序一致性==：任何执行（对数据存储的一组 操作）的结果是相同的，就好像所有进程的读和写操 作按某种定序执行。要求是所有客户看到的是同一个有 效全局定序</li>
<li>==因果一致性==：只要求因果关系的写操作在所有的副本上看到按同样的次序被执行，所有进程必须以相同的顺序看到具有潜在因果关系 的写操作。不同机器上可以不同的顺序看到并发写操作。</li>
<li>==FIFO 一致性==：它关心 一个客户的操作定序，取消了对并发操作定序的任何限制，只要求一个 客户的写操作定序在所有副本上是相同的定序（即程序规定的操作次序 ）。</li>
</ul>
<h3>8.3 远程主副本协议 （远程写协议） p224</h3>
<ul>
<li>数据项有多个副本，但其中有一个 主副本。写操作都转发到主副本上进行，然后主副本 服务器通知其它副本对数据项进行修改。读操作是在 本地副本上执行。这种方法也称主机备份协议。</li>
</ul>
<h2>9. 容错性</h2>
<h3>9.1 基本概念</h3>
<ul>
<li>故障 导致 错误 归于 失败</li>
</ul>
<h3>9.2 拜占庭将军问题 p241</h3>
<ul>
<li>问题：有时候，系统中的成员计算机可能出错而发送错误的信息，用于传递信息的通讯网络也可能导致信息损坏，使得网络中不同的成员关于全体协作的策略得出不同结论</li>
<li>处理机个数：一个有K个故障机系统中，最少要有2k＋1个正常处 理机。处理机总数为3k+1才可以解决问题。</li>
<li>结论：在不可信网络上无法解决</li>
</ul>
<h3>9.3 可靠通信 p244</h3>
<h2>10. 安全性</h2>
<h3>10.1 安全性基本概念</h3>
<ul>
<li>分布式安全性要解决的两个问题：
<ul>
<li>通道安全（身份、消息安全） 和授权</li>
</ul>
</li>
</ul>
<h3>10.2 密码机制</h3>
<ul>
<li>对称加密系统：使用相同的秘钥进行一个消息的加密和解密</li>
<li>非对称加密</li>
</ul>
<h3>10.3 身份认证和授权工作</h3>
<ul>
<li>
<p>保证消息的完整性和机密性</p>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188596-2021-06-14image-20210614194558055MzDH4l.png" alt="image-20210614194558055" /></p>
<ul>
<li>
<p>使用哈希散列和消息摘要</p>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188601-2021-06-14image-20210614194703616g4WxuA.png" alt="image-20210614194703616" /></p>
</li>
</ul>
</li>
</ul>
<h3>10.4 alice 和 bob 通讯，他要做什么</h3>
<ol>
<li>身份认证，了解对方的身份：
<ul>
<li>共享秘钥</li>
<li>秘钥分发中心的身份认证</li>
</ul>
</li>
<li>授权，检查对方是否授予执行请求操作的权限</li>
<li>保证消息的完整性和机密性：
<ul>
<li>数字签名</li>
<li>会话秘钥</li>
</ul>
</li>
</ol>
<h2>11 任务分配调度 （书上无）</h2>
<h3>11.1 一般表调度算法：</h3>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188605-2021-06-14image-20210614195751346DcDtGD.png" alt="image-20210614195751346" /></p>
<h3>11.2 启发式算法：</h3>
<p><img src="https://www.pppp.ink/images/2021-06-20-1624188610-2021-06-14image-20210614195846066BHPA3j.png" alt="image-20210614195846066" /></p>
<h2>12 分布式文件系统</h2>
<ul>
<li>
<p>什么是分布式文件系统：</p>
<ul>
<li>文件系统是负责组织﹑存储﹑提取﹑命名﹑共享和保护文件, 文件除 了其内容(字节序列)外, 还有其属性, 如文件类型﹑创建时间等。文 件的符号名到内部标识(地址)的翻译由文件系统的目录实现。</li>
<li>文件系统对文件的管理包括对文件本身的管理, 文件属性管理和目录 管理。</li>
<li>存储信息一般以文件形式存储在各种服务器连接的存储介质中, 客户 端通过网络访问服务器中的文件, 这就构成一种分布式文件系统。</li>
<li>分布式文件系统的文件是通过网络传输的并为多个客户所共享, 因此 文件系统的管理功能还包括对客户的身份认证和根据客户权限对文件 执行访问控制</li>
</ul>
</li>
<li>
<p>分布式文件系统的三种体系结构</p>
<ul>
<li>客户－服务器体系结构
<ul>
<li>远程访问模式</li>
<li>上载/下载模式</li>
</ul>
</li>
<li>集群式体系结构：整个文件分布在多个服务器、对文件进行带区划分以进行并行访问 （GFS）
<ul>
<li>文件非常大，每个文件包含较小对象</li>
<li>每个GFS文件被划分为多个块，每个块64M</li>
<li>主服务器实际上维护了一个名称空间，从文件名到块的映射</li>
<li>可扩展性和可维护性好。</li>
</ul>
</li>
<li>对称式体系结构</li>
</ul>
</li>
<li>
<p>概论</p>
</li>
<li>
<p>体系结构：分布式要注意的基本问题，基本特征</p>
</li>
<li>
<p>经常喜欢出个题：谈谈分布式系统要解决什么问题</p>
<ul>
<li>都是分布式系统需要解决的问题：名字服务、进程在分布式中的特点</li>
</ul>
</li>
<li>
<p>分布式通信：</p>
<ul>
<li>分布式就是单机OS+ 通讯，通讯带来了非常多的问题</li>
<li>通讯的手段是什么，通信带来的问题是什么</li>
<li><strong>最最重要的：协议问题</strong></li>
<li>分布式的理想目标</li>
</ul>
</li>
<li>
<p>同步的问题：</p>
<ul>
<li>逻辑时钟是什么样的</li>
</ul>
</li>
<li>
<p>一致性和复制：</p>
<ul>
<li>为什么出现一致性：复制，为什么复制：扩展性</li>
</ul>
</li>
<li>
<p>容错：</p>
<ul>
<li>完备性
<ul>
<li>结果的正确性</li>
<li>系统出错</li>
</ul>
</li>
</ul>
</li>
<li>
<p>安全性：</p>
<ul>
<li>是什么，特点是什么，要强调的是什么</li>
</ul>
</li>
<li>
<p>文件系统：一个案例</p>
</li>
</ul>
<h2>OS管理</h2>
<ul>
<li>
<p>两个主线：</p>
<ul>
<li>分布式进程</li>
<li>围绕资源管理：资源分配、一致性、安全性</li>
</ul>
</li>
<li>
<p>进程通信：</p>
<ul>
<li>RPC、c/s。通信原语和协议</li>
</ul>
</li>
<li>
<p>分布式 OS 内容：图</p>
</li>
<li>
<p>学习方法</p>
<ul>
<li>需求，提炼问题，分解问题，找出研究点，动态、静态方法，</li>
<li>怎么解决问题：体系结构，np问题：做一点假设限制，提出算法，进行仿真、实现、分析、评测、对比、结论</li>
</ul>
</li>
<li>
<p>必考：什么是分布式操作系统 Andrew S. Tanenbaum：<strong>一组独立的计算机系统，但是对 用户 看起来像是一个 单一 的计算机</strong></p>
<ul>
<li>巨大争议和问题</li>
<li>分布式系统组织成中间件的形式，中间件层分布在多台计算机上</li>
</ul>
</li>
<li>
<p><strong>基本问题、基本特点</strong></p>
<ul>
<li>系统由并行执行部件组成</li>
<li>无全局时钟</li>
<li>无全局信息状态</li>
<li>系统部件可能失效</li>
<li>具有容错机制</li>
<li>多副本需要一致性，保证扩展性</li>
<li><strong>单机操作系统与分布式操作系统的区别</strong>
<ul>
<li>围绕基本特性，阐述自己的观点</li>
</ul>
</li>
<li><strong>网络操作系统与分布式操作系统的区别</strong></li>
</ul>
</li>
<li>
<p><strong>基本研究方法</strong></p>
<ul>
<li>必须做到四件事
<ul>
<li>资源可访问性</li>
<li>透明性、开放性、可扩展性</li>
</ul>
</li>
<li>Trade-off Max-min、集中式vs分布式问题</li>
<li>管理系统和数据本身是分布式的：DNS
<ul>
<li>解决分布式的问题，但本身是分布式</li>
</ul>
</li>
</ul>
</li>
<li>
<p><strong>透明性</strong></p>
</li>
<li>
<p><strong>可扩展性</strong></p>
<ul>
<li>哪些技术实现可扩展性</li>
<li>三种可扩展性技术是什么
<ul>
<li>就在书上第二章：隐藏通信时间、分布、</li>
</ul>
</li>
</ul>
</li>
<li>
<p>软件体系结构</p>
<ul>
<li>四种软件体系结构</li>
</ul>
</li>
<li>
<p><strong>进程迁移</strong></p>
<ul>
<li>技术的制高点</li>
<li>有什么办法(处理中间消息)
<ul>
<li>消息重定位</li>
<li>消息丢失恢复</li>
<li>消息丢失保护</li>
</ul>
</li>
<li>研究点</li>
<li>进程迁移的图：一群节点</li>
<li><strong>进程选举</strong>：MIT：LCR 证明体系：代表性的分布式算法，体会算法的执行
<ul>
<li>分布式中一般要有一个leader，层次结构，但leader具有分布式特征，动态选举，和固定leader不是一个概念</li>
</ul>
</li>
<li>三个方面的难点
<ul>
<li><strong>迁移过程中进程间通信的问题</strong>：给解决问题的思路</li>
</ul>
</li>
</ul>
</li>
<li>
<p><strong>负载平衡</strong></p>
<ul>
<li>进程迁移的三大研究策略
<ul>
<li>定位策略
<ul>
<li>自定位、</li>
<li>如何衡量</li>
</ul>
</li>
<li>WHEN 什么时候</li>
<li>which 选择哪一个任务
<ul>
<li>远程执行、进程迁移</li>
<li>目标：受益大于开销</li>
</ul>
</li>
</ul>
</li>
</ul>
</li>
<li>
<p><strong>通信</strong></p>
<ul>
<li>强调四种通信：考名词解释，最简单的解释：持久、瞬时</li>
<li>简述：展开描述基本原理</li>
<li>算法策略问题，论述</li>
<li>flip 通信结构
<ul>
<li>特别好的思想：分布式典型结构，给一个进程一个地址（从根本上解决了）、相当于 iP 协议（不作为考试）</li>
</ul>
</li>
<li>RPC 重点：原理、参数传递、步骤、编码、同步异步</li>
<li>消息类型：
<ul>
<li>瞬时通信</li>
<li>持久通信</li>
</ul>
</li>
</ul>
</li>
<li>
<p><strong>命名系统</strong></p>
<ul>
<li>常见：结构化命名</li>
<li>基于属性的命名</li>
<li>无层次命名</li>
<li>知道一些命名方法</li>
<li>什么是递归名称解析，迭代名称解析</li>
</ul>
</li>
<li>
<p><strong>同步</strong></p>
<ul>
<li>重点：逻辑时钟问题
<ul>
<li>什么是逻辑时钟</li>
<li>核心：lamport 逻辑时钟算法，时钟是怎么走的，他给出了一个算法</li>
</ul>
</li>
<li>欺负算法
<ul>
<li>写一个进程选举的算法</li>
</ul>
</li>
</ul>
</li>
<li>
<p><strong>一致性和复制</strong></p>
<ul>
<li>为什么需要复制，复制带来的问题</li>
<li>一致性的模型：又强变弱
<ul>
<li>顺序、因果、fifo</li>
<li>因果一致性</li>
</ul>
</li>
<li>远程主副本协议
<ul>
<li>读本地、写主副本</li>
</ul>
</li>
</ul>
</li>
<li>
<p>共享语义</p>
</li>
<li>
<p>容错</p>
<ul>
<li>拜占庭将军问题
<ul>
<li>几个节点能解决</li>
<li>基本原理：四个节点</li>
<li>结论：在不可信网络上无法解决，能解决的节点个数 3k+1</li>
</ul>
</li>
<li>检查点机制（不考试）（有用）‘</li>
<li>可靠通信</li>
</ul>
</li>
<li>
<p><strong>安全性问题</strong></p>
<ul>
<li>解决：通道安全和授权两个问题</li>
<li>密码机制
<ul>
<li>对称密码、非对称密码，什么是（解决消息安全问题）</li>
</ul>
</li>
<li>身份认证、授权工作原理
<ul>
<li>私钥加密，哈希，公钥解密</li>
<li>a y要 和 b 通信的话，他要做什么</li>
<li>如何去查询是否有权限</li>
</ul>
</li>
</ul>
</li>
<li>
<p><strong>调度算法</strong></p>
<ul>
<li>一般表调度算法：DAG</li>
<li>启发式算法
<ul>
<li>Sarkar</li>
</ul>
</li>
</ul>
</li>
<li>
<p><strong>分布式文件系统</strong></p>
<ul>
<li>什么是分布式文件系统</li>
</ul>
</li>
<li>
<p>基本方法、研究点</p>
</li>
<li>
<p>面临的问题，具体知识点</p>
</li>
<li>
<p>都是课堂上的基本点</p>
</li>
<li>
<p>发挥</p>
</li>
<li>
<p>没必要打印所有ppt</p>
</li>
</ul>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-20T11:19:32.001Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[北航相关文档]]></title>
        <id>https://www.pppp.ink/docs/buaa/</id>
        <link href="https://www.pppp.ink/docs/buaa/"/>
        <updated>2021-06-21T11:39:11.000Z</updated>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-20T11:19:32.001Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[记一次备案]]></title>
        <id>https://www.pppp.ink/blogs/1-bei-an.html</id>
        <link href="https://www.pppp.ink/blogs/1-bei-an.html"/>
        <updated>2026-10-25T12:28:36.000Z</updated>
        <summary type="html"><![CDATA[pppp.ink 的坎坷备案路 上一次备案好像还在 2016 年，那时我刚上大一、遥想当年备案还需要邮寄幕布然后拍照上传。为何时隔多年我又要...]]></summary>
        <content type="html"><![CDATA[<p><code>pppp.ink</code> 的坎坷备案路</p>
<h2>缘由</h2>
<p>上一次备案好像还在 2016 年，那时我刚上大一、遥想当年备案还需要邮寄幕布然后拍照上传。为何时隔多年我又要备案了呢？因为买了新的域名，但这次备案比上次还要一波三折。</p>
<h2>备案</h2>
<p>我现在国内的服务器，已经迁到了腾讯云，所以首先我尝试在腾讯云备案域名 <code>pppp.ink</code>。好久不见，现在的备案流程已经有了巨大变化，云服务商不再邮寄幕布了，而是改为了视频核验。</p>
<p>我之前以为，新的域名可以在新的省份备案，万万没想到的是，因为我之前在陕西已经备案了一个域名，所以我这次备案是已新增网站的方式进行的，主体信息不能变更，不能迁往别的省份。如果我想在北京备案的话，就得先注销掉原来的域名 <code>sumblog.cn</code> 的备案，这让人难以接受。所以只能使用陕西的主体身份继续备案。</p>
<p>腾讯云的视频核验非常坑，备案时，需要（只能）使用微信小程序进行个人备案。</p>
<p><img src="https://www.pppp.ink/images/2021-06-19-1624102613-tHiCkC.jpg" alt="2021-06-19-1624102613-tHiCkC" /></p>
<p>最关键的一点是视频核验时，他还会通过微信小程序进行定位，判断你是不是在备案主体所在地。如果不在，他会拒绝进行人像核验。</p>
<p>但我本人又不在陕西，那怎么继续备案呢... 只能用一些奇怪的方法备案了</p>
<p><img src="https://www.pppp.ink/images/2021-06-19-1624102652-rbfpJO.jpg" alt="2021-06-19-1624102652-rbfpJO" /></p>
<blockquote>
<p>开心的一点，在我正在写这篇文章的时候，腾讯云居然给我打来了电话，向我核实了信息，貌似腾讯云初审直接通过了！</p>
</blockquote>
<p>接下来，又是漫长的等待...</p>
<h3>6 月 19 日</h3>
<p>腾讯云初审已经通过，腾讯云已经提交信息到管局，已经通过短信核验</p>
<p><img src="https://www.pppp.ink/images/2021-06-19-1624102680-hrOtNQ.jpg" alt="备案状态" /></p>
<h2>6 月 23 日</h2>
<p>ICP 备案通过，撒花</p>
<p><img src="https://www.pppp.ink/images/2021-06-23-1624452003-MMFk6U.png" alt="备案结果" /></p>
<p>接下来是公安备案</p>
<h2>6 月 26 日</h2>
<p>公安备案没有通过，临时下线本文章，等待公安备案</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-18T02:51:07.913Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[plugin]]></title>
        <id>https://www.pppp.ink/docs/theme-reco/plugin.html</id>
        <link href="https://www.pppp.ink/docs/theme-reco/plugin.html"/>
        <updated>2021-06-08T02:07:40.000Z</updated>
        <summary type="html"><![CDATA[This is plugin.]]></summary>
        <content type="html"><![CDATA[<p>This is plugin.</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-08T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[api]]></title>
        <id>https://www.pppp.ink/docs/theme-reco/api.html</id>
        <link href="https://www.pppp.ink/docs/theme-reco/api.html"/>
        <updated>2021-06-08T02:07:40.000Z</updated>
        <summary type="html"><![CDATA[This is api.]]></summary>
        <content type="html"><![CDATA[<p>This is api.</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-08T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[PPPP.ink 的第一篇文章]]></title>
        <id>https://www.pppp.ink/blogs/diary/2021/0608.html</id>
        <link href="https://www.pppp.ink/blogs/diary/2021/0608.html"/>
        <updated>2021-06-26T02:59:19.000Z</updated>
        <summary type="html"><![CDATA[一切就从这里开始]]></summary>
        <content type="html"><![CDATA[<p>一切就从这里开始</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-08T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[vuepress-theme-reco]]></title>
        <id>https://www.pppp.ink/blogs/other/guide.html</id>
        <link href="https://www.pppp.ink/blogs/other/guide.html"/>
        <updated>2021-06-08T02:07:40.000Z</updated>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-08T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[theme-reco]]></title>
        <id>https://www.pppp.ink/docs/theme-reco/</id>
        <link href="https://www.pppp.ink/docs/theme-reco/"/>
        <updated>2021-06-08T02:07:40.000Z</updated>
        <summary type="html"><![CDATA[This is theme-reco.]]></summary>
        <content type="html"><![CDATA[<p>This is theme-reco.</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-08T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[theme]]></title>
        <id>https://www.pppp.ink/docs/theme-reco/theme.html</id>
        <link href="https://www.pppp.ink/docs/theme-reco/theme.html"/>
        <updated>2021-06-08T02:07:40.000Z</updated>
        <summary type="html"><![CDATA[This is theme.]]></summary>
        <content type="html"><![CDATA[<p>This is theme.</p>
]]></content>
        <author>
            <name>SincereXIA</name>
            <uri>https://www.pppp.ink/</uri>
        </author>
        <published>2021-06-08T00:00:00.000Z</published>
    </entry>
</feed>